Anthropicが2026年9月22日、対話AI「Claude」の新モデル「Opus 5.5」を発表した。API価格は入力・出力とも2割引き下げられ、独立系の測定機関Artificial Analysisが公表した知能指数では歴代最高の58点を記録している。
だが数字を並べてみると、単純な「安くて賢くなった」では済まない裏がある。値下げされたのは1トークンあたりの単価であって、複雑な仕事をこなすときにモデルが実際に使うトークンの総量は、旧モデルより増えているのだ。単価×使用量で決まる実際の請求額は、計算してみると旧モデルよりむしろ高くなる場面がある。
⚠ 情報の鮮度について
一次情報はAnthropic公式発表(2026年9月22日9時30分・米国太平洋時間)と、同日のTechCrunchの報道、および同日公開のArtificial Analysisの独立測定記事です。本記事公開時点で約30時間が経過しています。前日の記事では同じ日に伝えたOpenAIのGPT-6 Sol・Luna値下げの陰でOpus 5.5の値下げに一文触れただけだったため、ここでは独立測定の結果とコスト構造を掘り下げます。
Section 01
価格2割減・利用上限20%増──何が変わったのか
Opus 5.5は、2026年7月24日に登場したOpus 5から2か月足らずでの後継投入になる。まず動いたのは開発者向けAPIの価格表だ。
| 項目(100万トークンあたり) | Opus 5 | Opus 5.5 | 変化 |
|---|---|---|---|
| 入力 | 5.00ドル | 4.00ドル | −20% |
| 出力 | 25.00ドル | 20.00ドル | −20% |
| キャッシュ読み込み | 0.50ドル | 0.20ドル | −60% |
| キャッシュ書き込み | 6.25ドル | 5.00ドル | −20% |
| Fastモード(新設・入力/出力) | ─ | 8.00ドル / 40.00ドル | 新設 |
58点
独立測定の知能指数(歴代最高)
40%
典型的な使い方でのコスト減(Anthropic自己申告)
20%
サブスクの5時間利用上限の引き上げ幅
一言でまとめると──単価は下がりましたが、それだけでは請求額は決まりません。使うトークンの量まで見ないと、実際に安くなったかどうかは分からない改定です。
Section 02
独立測定で歴代最高58点、Fable 5.1やAstraを上回る
Artificial Analysisは、複数の評価項目を1つの数字にまとめた「知能指数」を独自に測定し、モデルの一覧を公開している媒体だ。ベンダー自身の発表数値とは別に、第三者が同じ条件で全モデルを動かして採点する。
| モデル | 知能指数(最大努力度) |
|---|---|
| Claude Opus 5.5 | 58点首位 |
| Claude Fable 5.1 | 53点 |
| GPT-6 Astra(OpenAI) | 53点 |
| Claude Opus 5 | 51点 |
58点は、Artificial Analysisがこれまでに測定した中で最も高いスコアだという。個別の評価でも、難問集「Humanity's Last Exam」で61.4%(それまでの最高は59.1%でFable 5.1)、プログラミング系の「SciCode」で66.9%(63.1%)、知識労働を測る「AA-Briefcase v1.1」で1,822 Eloと、Fable 5.1に対して143ポイントの差をつけている。
ⓘ Anthropic自身が示す数字は別の顔をしている
Anthropicが独自に行ったベンチマークでは、エージェント型のコーディングを測る「Terminal-Bench 4.0」でOpus 5.5が66.4%(Fable 5.1は55.8%)、複数分野の推論課題で67.7%(65.6%)としています。同じ「Fable 5.1超え」という結論でも、測定元がAnthropic自身か、外部のArtificial Analysisかで、使う評価項目も数字も違います。両方を見比べたうえで判断するのが安全です。
Section 03
「40%安い」のに、複雑な仕事は逆に高くなる
ここからが、価格表だけを見ていては気づけない部分だ。Artificial Analysisは知能指数の測定と同時に、各モデルが1つの課題を解くのに実際に使った出力トークンの量も記録している。Opus 5.5を最大努力度で動かした場合、1タスクあたり平均で約119,000トークンを出力した。旧モデルのOpus 5は約73,000トークン、Fable 5.1は約78,000トークン、OpenAIのGPT-6 Astraはわずか約27,000トークンだった。
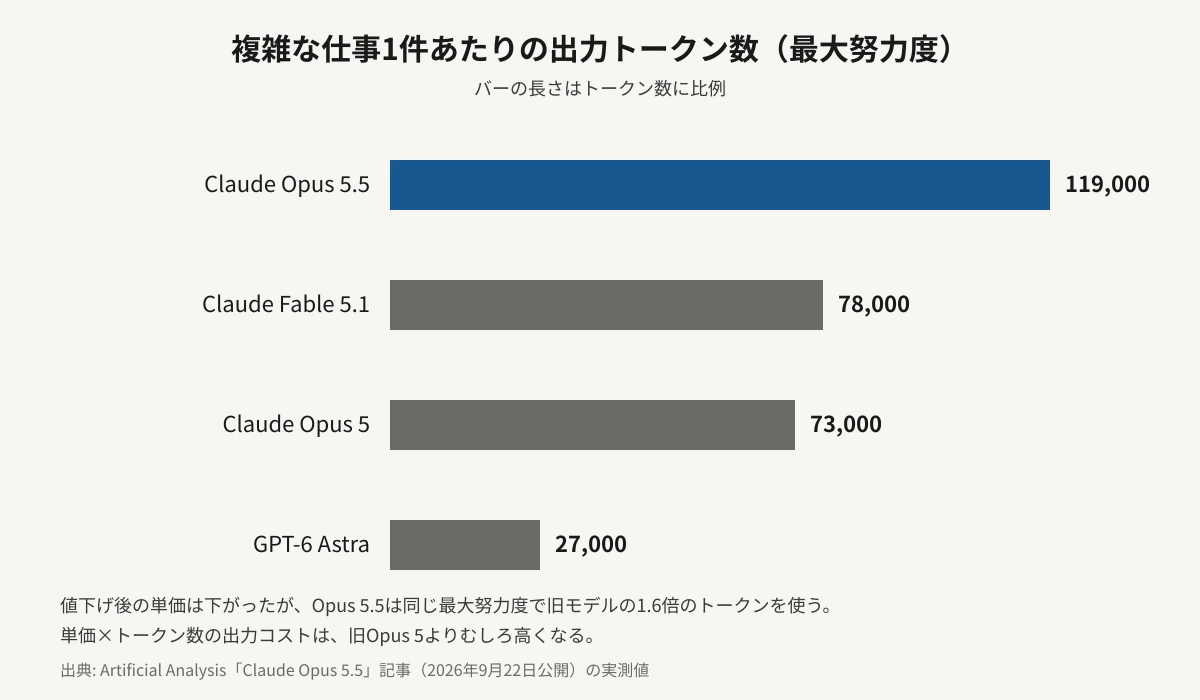
Opus 5.5はOpus 5に対して、1タスクで使うトークンが約1.6倍に増えている。ここで単価と使用量を掛け合わせて実際の出力コストを計算してみる。
Opus 5.5:出力単価20.00ドル×119,000トークン÷100万=2.38ドル。旧Opus 5:出力単価25.00ドル×73,000トークン÷100万=1.825ドル。同じ「最大努力度で1タスク」という条件で比べると、Opus 5.5のほうが約30%高い計算になる。
— Artificial Analysisの実測トークン数と両モデルの公表単価をもとに編集部で算出(2026年9月22日時点の単価)
ここには、もう1つ知っておくべき事情がある。Anthropicの開発者向けドキュメントによれば、Opus 5.5は「努力度(effort)」設定の既定値がmediumに下がった。旧Opus 5をはじめ他の多くのモデルは既定がhighで、明示的に努力度を指定しない呼び出しは、Opus 5.5では旧モデルより1段低い設定で動く。だからこそ、努力度を指定しない一般的な使い方では、単価の低下と既定の努力度の低下が重なり、Anthropicの言う「40%安い」が実感に近くなる可能性が高い。今回計算した約30%高いという結果は、努力度をmaxまで上げて難問を解かせた場合に限った話だ。
💡 APIを使う人が確認すべきこと
本番環境で旧モデルからOpus 5.5に切り替える前に、まず自分が指定している努力度(effort)を確認してください。既定値のまま、あるいはlow・medium相当で使っているなら、単価の低下がそのまま請求額の減少につながる可能性が高いです。一方でmax・xhighまで上げて難問を解かせる使い方をしているなら、実際の入力を20〜30件ほど流し、消費トークン数と請求額を旧モデルと比べてから切り替えることをお勧めします。
Section 04
サブスク側は利用上限アップとリセット1回分
ここまではAPIを従量課金で使う場合の話だ。ChatGPTと同じように、Claude.aiやClaude Codeを月額プランで使っている人には、別の変更が入る。
ⓘ 月額プラン利用者への変更点
AnthropicはPro・Max・Team、および座席制のEnterpriseプランで、5時間ごとの利用上限を20%引き上げました。処理コストが下がった分と合わせ、「実質的には上限が25%長持ちする」としています。加えて、サブスク利用者全員に、好きなタイミングで使える1回分のレート制限リセットが付与されます。
月額プランは使用量に応じた従量課金ではなく、上限までは追加費用が発生しない仕組みだ。したがって前の章で触れたトークン消費量の増加は、月額プラン利用者の請求額には直結しない。上限に到達しやすくなるかどうかが、こちらの利用者にとっての実質的な論点になる。
Section 05
編集部の見立て
Editor's Opinion
今回の発表で注目したいのは、58点という首位の数字そのものより、「単価は下がったのに、測ってみると高くなる場面がある」という組み合わせのほうです。前日に伝えたGPT-6 Sol・Lunaの値下げでは、下位モデルの単価が下がる一方で最上位のSolは据え置かれ、シリーズ内の価格差が開いていく構図でした。Opus 5.5はその逆で、単価そのものは下がっているのに、実際の仕事量に応じたコストは据え置き、あるいは条件によっては上がるという、もう一段ねじれた形で出てきています。
値下げの見出しだけを信じて予算を組むと、重い仕事を大量にこなす使い方ほど計算が狂います。逆に、軽い分類・整形・下書きのような仕事であれば、単価の低下がそのまま請求額の減少に結びつく可能性が高いと考えます。同じ改定でも、どの努力度でモデルを使っているかによって、受け取る恩恵の大きさがまったく違うということです。
Anthropicが自社のベンチマークで「効率が上がった」とする指標と、外部のArtificial Analysisが実測した「トークン消費量が増えた」という指標が、同じ発表の中で両方とも真実であり得る点も興味深いところです。測定の切り口が違えば、同じモデルについて逆方向の印象を持つ説明が両方成立してしまいます。片方の数字だけを見て判断しないという姿勢が、今回のような改定では特に必要になると考えます。
数週内に投入が予告されているSonnet 5.5・Haiku 5.5でも、同じ形のねじれが起きるのかどうかは、まだ分かっていません。次にその価格表とベンチマークが出たとき、まず確かめるべきはそこです。
Section 06
まとめ
Anthropicが2026年9月22日、Claude Opus 5.5を発表しました。API価格は入力4.00ドル・出力20.00ドル(いずれも2割引き下げ)、キャッシュ読み込みは0.20ドルへと6割下げられています。独立測定機関Artificial Analysisの知能指数では58点を記録し、Claude Fable 5.1・GPT-6 Astraの53点、旧Opus 5の51点を上回って歴代最高となりました。
一方で、最大努力度での1タスクあたりの出力トークン数は約119,000と、旧Opus 5の約73,000から1.6倍に増えています。公表単価で計算すると、出力コストはOpus 5.5のほうが旧Opus 5より約30%高くなる場面があります。「単価が下がった」ことと「請求額が下がった」ことは、同じではありません。
月額プラン利用者には従量課金の話は関係せず、Pro・Max・Team・Enterprise(座席制)で5時間利用上限が20%引き上げられ、好きなタイミングで使える1回分のレート制限リセットが付与されます。
複雑な仕事にどれだけAPIコストをかけているかが分かっていない人ほど、値下げの見出しだけで乗り換えを決めるのは早い。まず自分の努力度設定で、実際のトークン消費量を確かめてから判断したい。