GitHub Copilot が2026年9月30日、複数のAIモデルを1回の依頼の中で組み合わせる「HydraFusion」を、VS Codeと専用のCopilotアプリで使えるようにした。9月上旬にコマンドライン版(Copilot CLI)だけで始まった研究プレビューが、普段のエディタに降りてきた形だ。
仕組みを一言でいえば、依頼ごとに「どのモデルで解くか」ではなく「どういう手順で解くか」を選ぶ機能である。1つのモデルに任せる日もあれば、安いモデルが下書きして出来が悪ければ強いモデルに引き継ぐ日もあり、別系統のモデルに点検させる日もある。
GitHubが公表した評価では、Anthropicの高性能モデルClaude Opus 5に対し、ある試験で推定コストを67%減らしながら品質は上回ったという。ただしこの数字は読み方に癖がある。請求にも、モデルを自動で選ぶ既存の「Auto」とは違う扱いが1点ある。この記事では、その2つを分けて整理する。
⚠ 情報の鮮度について
一次情報はGitHub公式の変更履歴(2026年9月30日付)です。研究プレビューそのものの説明と試験結果は、同じくGitHub公式ブログの2026年9月4日付の記事に基づきます。公開時点で、VS Code・アプリへの拡大からおよそ1〜2日が経過しています。ここで扱う内容はいずれも研究プレビュー段階のもので、GitHubも手順やモデルが変わりうると説明しています。
Section 01
HydraFusionとは何か──9月30日にVS Codeとアプリへ
HydraFusionは、Copilotのモデル選択欄(モデルピッカー)に並ぶ1つの選択肢として現れる。ただし中身は1つのモデルではなく、複数のモデルを束ねて動かす司令塔だ。GitHubはこれを、実行手順の選択を最適化の問題として扱う仕組みだと説明している。依頼の内容から、推論力・コード生成・デバッグ・ツール利用といった手がかりを読み取り、次の3つの手順から選ぶ。
01
Single:1つのモデルで解く
1つのモデルが直接解く、いちばん単純な手順。簡単な依頼なら、これで足りるという判断になる。
02
Cascade:安いモデルから始める
効率のよいモデルが下書きを書き、品質の関門が「このまま採用するか、強いモデルに引き継ぐか」を決める。うまくいけば安く済み、難しければ上へ回る。
03
Critique:別のモデルに点検させる
1つのモデルが下書きし、別系統のモデルが審査し、下書きしたモデルが1回だけ直す。審査役を別系統のモデルにする点が特徴だ。
9月30日の変更履歴で動いたのは、提供場所の拡大である。VS Codeはバージョン1.140以降で、モデルピッカーから HydraFusion を選べる。表示されない場合は設定で有効にする。Copilotアプリでも、最新版に更新して設定から有効にし、モデルピッカーで選ぶ。対象はCopilot Pro・Pro+・Business・Enterpriseで、BusinessとEnterpriseでは管理者がプレビュー機能を有効にしている必要がある。
あわせて、途中経過が見えやすくなった。手順の各段階で何をしているかが分かりやすくなり、進捗の更新が増えて、長い作業でも動き続けていることが読み取りやすい。
一言でまとめると──「HydraFusionは新しいモデルではなく、既存のモデルを組み合わせる手順の選び方」です。VS Codeで使えるようになったのは2026年9月30日からで、まだ研究プレビューの段階です。
Section 02
Autoとの違い──選ぶのはモデルではなく「進め方」
Copilotにはすでに、モデルを自動で選ぶ「Auto」がある。GitHubの説明では、Autoは依頼ごとにモデルを1つ選ぶ。HydraFusionは1回のやり取り(ターン)の中で手順を選び、複数のモデルを連携させる。違いは、選ぶ単位が「モデル」か「手順」かにある。
Autoは2026年9月14日に、効率・バランス・知能という3段階の設定が加わったばかりだった。詳しい経緯はGitHub Copilot「Auto」に3段階設定の記事にまとめている。Autoの3段階は、モデルの選び方の方針を切り替える設定だった。HydraFusionは、1回の依頼の中で複数のモデルを呼ぶところまで踏み込んでいる。
同じ方向の動きは他社にもある。Cursorが7月に投入した「Router」は、依頼ごとに最適なモデルを割り振る機能で、Router正式投入の記事で扱った。CursorのRouterが依頼単位の振り分けなのに対し、HydraFusionは1依頼の内側で分業する点が違う。コード支援AIは、モデルの性能を競う段階から、モデルの使い回し方を競う段階に移りつつあるように見える。
ⓘ 使うモデルは、利用者には選べません
HydraFusionが使うモデルは固定の一覧ではなく、簡単な作業には速いモデル、難しい作業には推論の強いモデルを動的に選びます。利用者がモデルを指定することはできません。ただし、どのモデルが使われたかは、VS Codeやアプリでは完了した回答のフッターにカーソルを重ねると確認できます。コマンドライン版では /usage を入力すると、モデルごとに消費したクレジットが見られます。
Section 03
67%減という数字の読み方
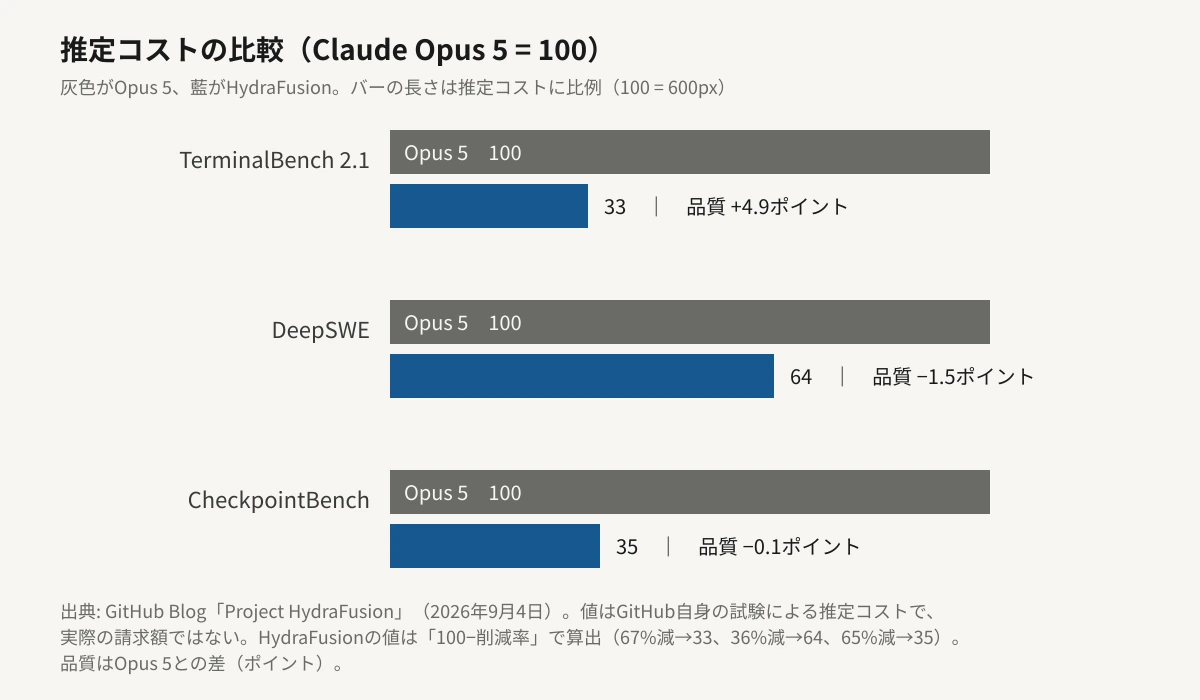
GitHubが9月4日に公表した研究報告は、3つのベンチマーク(AIの性能を測る共通の試験)で、HydraFusionをClaude Opus 5と比べている。Claudeの高性能モデルを基準にした比較だ。結果は次のとおりである。
| ベンチマーク | 品質(Opus 5との差) | 推定コスト(Opus 5比) |
|---|---|---|
| TerminalBench 2.1 | +4.9ポイント | 67%減 |
| DeepSWE | −1.5ポイント | 36%減 |
| CheckpointBench | −0.1ポイント | 65%減 |
67%
推定コストの減少幅(TerminalBench 2.1)
+4.9
同じ試験での品質差(ポイント)
36%
DeepSWEでの減少幅(品質は−1.5)
3つを並べると、コストが下がる幅は36%から67%まで開いており、品質はOpus 5をわずかに上回る試験もあれば、わずかに下回る試験もある。「67%安くて品質も上」が当てはまるのは3試験のうち1つだけで、DeepSWEでは36%減と引き換えに1.5ポイント下がった。見出しの数字だけを持ち帰ると、この幅が消える。
数字の前提も確認しておきたい。GitHubは、この結果が評価に使った試験の版・手順の設定・モデルの組み合わせ・価格の仮定に固有であり、すべてのモデルを同じ推論の強さ(medium)にそろえた管理下のオフライン評価だと明記している。コストは、下書き・点検・修正・引き継ぎ・再試行・代替といった、呼び出したすべての段階を合算した推定値である。そして、試験を行ったのはGitHub自身だ。第三者による再現は、現時点では確認できていない(※観測)。
得意な作業の範囲も限られている。GitHubは、最初の1回の指示で完結するコーディング作業に向くと説明している。
Section 04
HydraFusionの料金と請求で見落としやすい点
HydraFusionに専用の料金は設定されていない。使った分は、中で呼ばれた各モデルの標準の料金で、トークン消費量に応じて請求される。ここまでは分かりやすい。
見落としやすいのは次の2点である。第1に、GitHubのドキュメントは「Autoのモデル自動選択に付く割引は適用されない」と書いている。Autoでは有料プランが利用時の料金から10%引きになるが、HydraFusionにはそれが付かない。第2に、複数のモデルを使う作業は、1つのモデルで済ませる作業よりクレジットを多く消費する。Cascadeで下書きが採用されなかった場合や、Critiqueで審査と修正が入る場合は、呼び出しの回数がそのまま積み上がる。
A
試験の「推定コスト」は、請求書の数字ではない
67%減はOpus 5を単独で使った場合との、GitHubの試算上の比較だ。実際の請求は、あなたの作業でどの手順が選ばれ、何回モデルが呼ばれたかで決まる。
B
Autoの割引が消える
Autoで10%引きになっていた人が、同じ作業をHydraFusionに切り替えると、単価の面では割引を失う。手順の工夫による節約が、その分を上回るかどうかは作業次第になる。
C
やり直しの下書きは、取り消されない
途中で捨てられた下書きが作業フォルダに加えた変更は、自動では元に戻らない。ドキュメントはこの点を制限事項に挙げている。
💡 そのほかの制限
HydraFusionはサブエージェント(作業を分担する別のAI)とは別系統で動き、サブエージェントを起動しません。途中の下書きは、最終結果が出るまで表示されない仕様です。Business・Enterpriseでは、組織が許可しているモデルの範囲内でしか選ばれません。手順やモデルはプレビュー中に変わる可能性があると、GitHubは説明しています。
Section 05
あなたはどう試すか
研究プレビューなので、普段の主力にするよりも、小さな実験で挙動を見るほうが向く。立場ごとに、確かめる点が違う。
A
Pro・Pro+で個人利用:1回で終わる作業で比べる
関数1つの追加やバグ1件の修正など、1回の指示で完結する作業を選ぶ。同じ依頼をAutoとHydraFusionで1回ずつ流し、回答のフッターにカーソルを重ねて使われたモデルを見て、消費クレジットを並べる。GitHubが向くと説明しているのは、最初の1回の指示で完結する作業だ。
B
Business・Enterpriseの管理者:まず有効化の判断
プレビュー機能の有効化は管理者の操作になる。選ばれるモデルは組織のモデルポリシーの範囲に限られるので、許可していないモデルが勝手に使われることはない。一方で、クレジットの消費が増えうる点は、試す前に共有しておきたい。
C
Cursorなど他のツールを使っている人:比べる軸が増えた
モデルの性能表だけでなく、「1回の依頼の中でモデルをどう使い回すか」が比較項目に加わった。ただしHydraFusionの数字はGitHubの試験のもので、他のツールの割り振りと同じ条件で比べた結果はまだ出ていない。
Section 06
編集部の見立て
Editor's Opinion
今回いちばん興味深いのは、67%という数字よりも、「モデルを選ぶ」から「手順を選ぶ」へ競争の単位が動いたことだと考えます。Autoが依頼ごとにモデルを選び、HydraFusionが1回の依頼の中で手順まで選ぶ。選択の粒度が細かくなるほど、使う側から見える部分は減っていきます。
見えにくくなることには、利点と引き換えがあります。利点は、難しさに応じて安いモデルと強いモデルを使い分けてもらえることです。引き換えに、請求の内訳が読みにくくなります。HydraFusionは、使ったモデルを回答のフッターへのカーソル操作で確認できるようにしていますが、確認する手間は利用者の側にあります。
もう1つ気になるのは、検証の主体です。試験はGitHub自身が行い、見出しの比較相手に選んだのはAnthropicのOpus 5でした。数字が誤っているという意味ではありません。ただ、結果が出そろうまでは、67%減を「Copilotで実際に起きること」ではなく「GitHubの試験で起きたこと」として扱うのが妥当でしょう。DeepSWEのように、コストが36%しか下がらず品質も少し落ちた試験が、同じ報告書に載っていることも、読み取る価値があります。
プレビューを抜けるときに、Autoの割引が付くのか、請求の内訳がどこまで見えるのか。この2点が、HydraFusionを日常使いに置けるかどうかの分かれ目になると見ています。
Section 07
まとめ
2026年9月30日、GitHub CopilotはHydraFusionをVS Codeと専用のCopilotアプリに広げました。対象はCopilot Pro・Pro+・Business・Enterpriseで、BusinessとEnterpriseは管理者がプレビュー機能を有効にする必要があります。
HydraFusionは新しいモデルではなく、Single・Cascade・Critiqueという3つの手順から依頼ごとに選び、複数のモデルを1回のやり取りの中で連携させる仕組みです。Autoが依頼ごとにモデルを選ぶのに対し、手順まで選ぶ点が違います。
GitHubの試験では、Claude Opus 5に対して推定コストがTerminalBench 2.1で67%減(品質は+4.9ポイント)、DeepSWEで36%減(同−1.5ポイント)、CheckpointBenchで65%減(同−0.1ポイント)でした。第三者による再現は確認できておらず、※観測の段階です。
専用の料金はなく、中で呼ばれたモデルの標準料金で請求されます。Autoの割引は適用されず、複数のモデルを使う作業はクレジットの消費が増えることがあります。
VS Codeのモデルピッカーに並んだ1行の裏で、どのモデルが何度呼ばれたのか。それを確かめる手段は、いまのところ回答のフッターへのカーソル操作と、コマンドライン版の /usage だけだ。プレビューの間に、請求の画面がその内訳をどこまで見せるのかが、次の確認点になる。