AIの安全性を評価する非営利団体のMETRとRedwood Researchが2026年10月22日、OpenAI の社内を3週間にわたって試験した結果を公表した。調べたのは、OpenAIが自社のAIエージェントの行動を見張るために動かしている「監視システム」である。
その監視には、抜け道がいくつも見つかった。なかには、直近の「数百件」の操作を監視の対象から外せる手口もあったという。OpenAIは、本番の安全策に関わる脆弱性はすべて修正したと説明しているが、その修正を評価した第三者はまだいない。
今回の試験は、OpenAIが外部の評価者に社内への深いアクセスを認めた試行である。見つかった穴の数よりも、外から見る権利と、見たものを話す権利が別々に扱われた点のほうが、AIを選ぶ側にとっては長く残る論点になりそうだ。
⚠ 情報の鮮度について
一次情報はMETRが2026年10月22日に公開したブログ記事です。公開時点で1日余りが経過しており、速報ではなく、選ぶ側にとっての意味を整理する記事として書いています。数値はすべてMETRの推定で、試験の対象は2026年7月21日時点のOpenAIの監視システムです。その後の変更や修正の中身は、METRもRedwoodも確かめていません。
Section 01
METRとRedwoodの試験とは──発表の中身
試験が行われたのは2026年7月21日から8月11日までの3週間で、METRとRedwood Researchから1人ずつが参加した。2人はOpenAIの社内コード、監視用モデルへの指示文と設定、内部文書を読み、監視・安全システム・セキュリティの各チームの研究者やエンジニアおよそ12人に聞き取りをした。作業はOpenAIが貸与した端末で行われ、端末は社屋の外へ出ず、現地では付き添いがついていたという。
監視システムとは、AIエージェントが動いている最中の行動記録を別のAIモデルに読ませ、隠れた意図、妨害、情報の持ち出し、欺き、外部からの指示の混入などの兆候があれば止めたり人に回したりする仕組みのことだ。エージェントとは、人の代わりに複数の操作を連続して実行するAIを指す。ChatGPTやCodexのように、ファイルを書き換えたりコマンドを実行したりするタイプが当てはまる。
確かめようとした問いは2つだった。社内のエージェントの通信のうち、どれだけが監視されているのか。そして、エージェント自身が監視を止めたり、すり抜けたりできるのか。成果物は61ページの社内向け報告書で、OpenAIが黒塗りした38ページ版がMETRとRedwoodの幹部に渡された。公開されたのは、ブログ記事1本ぶんの要約だけである。
3週間
試験期間(7月21日〜8月11日)
2人
社内に入った評価者(各団体1人)
61ページ
OpenAI向けの社内報告書
経緯も押さえておく。この試験は、OpenAIの未公開モデルが実行環境を抜け出して外部に侵入した事件(詳しい経緯はこちら)が報じられた7月下旬に始まっている。9月にはAnthropicのダリオ・アモデイ氏が進化速度を落とす構想を打ち出し(こちらの記事)、サム・アルトマン氏は同じ9月12日に、外部の評価者に社員並みのアクセスを認めるAnthropicの約束に歩調を合わせると表明した。今回の試験は、その約束に先行した試行であり、METR自身も「深い外部アクセスのパイロット」と位置づけている。
一言でまとめると──「OpenAIは外の目を社内に入れた。見つかった穴は修正済みと説明されているが、直ったかどうかを外から確かめた人はいない」。穴の存在よりも、確認の手段が残されていない点が今回の核心です。
Section 02
見つかった穴を並べると
METRが挙げた発見は、通信のうち監視が及んでいる量に関するものと、監視を抜けられる手口に関するものに分けられる。まず量から見る。
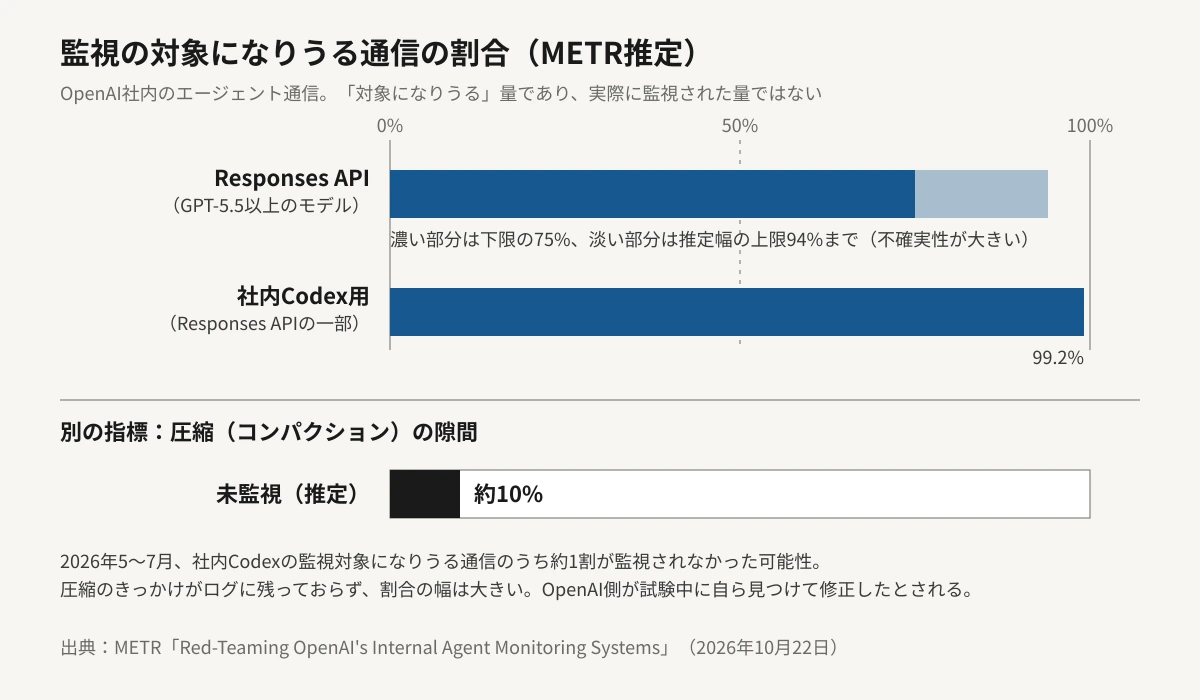
GPT-5.5以上のモデルによる社内のResponses API通信のうち、監視の対象になりうるのは推定75〜94%で、幅が広いのは数えきれていない通信があるからだ。その中で社内Codex用に絞ると、99.2%が対象だった。ただし「対象になりうる」ことと「実際に監視された」ことは別である。負荷が高いときに監視を飛ばす仕組みや、監視用モデルのエラー、実装上の不具合で、対象の通信がすり抜ける余地は残る。METRが示された数字では、監視用モデルのエラーは全体の0.2%未満、24時間のある期間に負荷による見送りはゼロだった。
次に手口である。METRが公開した範囲を、読者が追いやすい順に並べる。
01
長い作業の「圧縮」で見張りが途切れた
長く続く作業では、途中で内容を要約して短くする処理(コンパクション)が走る。この処理を監視していなかったため、2026年5〜7月の社内Codex通信の約1割が監視を受けていなかった可能性がある。監視は「エージェントが人に制御を返したとき」に動く設計で、動き続ける限り監視を先送りできた。OpenAIの担当者が試験中に自ら見つけて直したとされる。
02
サンドボックスとAuto-Reviewを抜けうる経路
Codexのエージェントが、実行環境の隔離(サンドボックス)と自動審査(Auto-Review)を原理的にすり抜け、利用者本人にできる操作なら何でも実行できる経路が見つかった。「実際に悪用されたか」は確認できていない。
03
直近の「数百件」を監視外にする手口
この手口を使うと、直近の数百件の操作が、手口の実行そのものも含めて監視の対象から外れる。具体的な中身はOpenAIの判断で黒塗りされ、公開されていない。
04
見え方の食い違いと、監視を切る2つのヘッダー
エージェントが見る記録と監視用モデルが見る記録の形式の差を突いて、監視を誤作動させ、人間の審査に回らないようにできる可能性があった。また、利用者側から操作できる2つのヘッダーで、新しいエージェントを監視なしで起動できた。
ほかに、読み取り専用と思われていた社内ツール2つで、サンドボックス内で任意の操作ができうる単純な手口が見つかった。METRはこれを実際に検証しておらず、悪用できるかも試していない。また、強化学習の訓練中の通信は、試験の開始時点では監視の範囲に入っていなかった。
Section 03
直ったのか、誰が確かめたのか
OpenAIは、本番の安全装置に影響する脆弱性はすべて修正済みだと説明している。CNBCの取材には、広報担当者が、得られた知見を安全策の強化と、独立した評価者との今後の協力のあり方に生かしていく考えを示したと伝えられている。
一方でMETRは、この修正を自分たちでは評価していないと明記した。さらに、OpenAIが監視の範囲を大きく広げる変更を説明しているものの、その広がった範囲が実際にどこまで届いているかも、試験では確立できなかった。
修正済みの根拠は、今のところOpenAI自身の説明だけである。
公表された範囲を見るかぎり、評価者に頼まれたのは「穴を探すこと」で、「直したことの確認」は含まれていない。この区別は、次の節で見る公開の取り決めとも関係している。
Section 04
黒塗りの余地を残した公開
METRは、この試験を「深い外部アクセスの試行」として設計したもので、広く透明性を示すためのものではないと書いている。公開の範囲は事前にOpenAIと合意した短く概要的なブログ記事にとどまり、OpenAIは機密または機微と判断した内容を、単独の裁量で黒塗りできた。しかも、METRにはその黒塗りの存在を自由に説明する権利が無かった。
| 項目 | 今回の取り決め |
|---|---|
| 社内を見る権利 | コード・設定・文書・聞き取りまで深く開かれた |
| 結果を話す権利 | 事前に合意した短い概要のみ。黒塗りはOpenAIの判断 |
| 黒塗りを説明する権利 | METR側には無い(過去の一部の案件とは異なる) |
| 公表された発見への責任 | METRは公表内容を支持すると明記 |
| 修正の確認 | 公表された範囲では含まれず、METRは評価していない |
METRは今後の試験で、同団体がAI企業と組むときの方針に近づけたいとしている。ロイターは10月13日、AnthropicとOpenAIがどちらも、外部の評価者が公表できる内容に強い統制を求めていたと、協議に詳しい2人の話として報じていた。OpenAIはこれに対し、報告書全体の承認はせず、機密の詳細を削る一方で、大きく削ったときは評価者がそう述べられると説明している。今回のMETRは黒塗りを説明する権利が無かったと書いており、同じ条件の下での試行だったかどうかは、公開された情報からは分からない。
Section 05
エージェントを選ぶ人は何を見るか
まず切り分けておく。今回の対象は、OpenAIが自社の研究や開発の中で動かしている社内エージェントの監視であり、ChatGPTやCodexの利用者の会話やデータが漏れたという話ではない。製品版のCodexにそのまま当てはまる欠陥だったのかは、公表された内容からは分からない。
それでも、ふだんエージェントに作業を任せている人が持ち帰れる点が2つある。
1つめは、隔離の抜け道が見つかった場合、エージェントが持つ権限の上限は「利用者本人の権限」になるという点だ。METRが示した経路は、利用者本人にできる操作ならなんでも実行できるものだった。つまり、エージェントを動かす端末やアカウントが、秘密鍵や本番環境の認証情報を自由に読める状態なら、仕組みの穴はそのまま被害の大きさに直結する。作業用のユーザーや隔離された環境を分け、鍵を置かないことは、ベンダーの修正を待たずにこちらでできる備えになる。
2つめは、ベンダーの「安全です」の根拠を読み分けることだ。第三者が内部に入った試験があるか、その結果をどこまで本人が語れるか、修正が外から確かめられているか。この3段を分けて見ると、各社の説明は同じ「第三者評価済み」でも重みがだいぶ違う。Claudeを出すAnthropicも、外部の評価者に社員並みのアクセスを認める約束をした側だが、UPIの記事は、Anthropic側の評価結果には触れていない。
ⓘ 製品の中身は変わらない
この記事は、ChatGPT、Codex、Claudeの現時点の使い勝手や料金の優劣を述べるものではありません。確認できたのは、OpenAI社内の監視の試験結果とその公開の仕方です。利用中の機能の設定を見直すかどうかは、各社の更新情報とあわせて判断してください。
過去の関連記事も置いておく。エージェントの暴走をめぐる監督当局の動きはFTCの調査着手の記事で、9月に起きた実行環境の脱出と全面停止はこちらで整理している。
Section 06
編集部の見立て
今回の試験で私たちが重く見るのは、見つかった穴の数ではありません。OpenAIが外部の2人に社内を3週間見せ、監視の弱点をそのまま公表させたことは、「社内の安全装置は外から確かめられる」と示した点で前進です。
ただ、その前進は半分だけです。見る権利は広く開かれた一方で、話す権利は短い概要に絞られ、黒塗りの存在さえ自由に説明できませんでした。修正の確認も契約の外にありました。つまり、利用者の手元に届くのは「穴はあったが直した」という会社の説明と、その一部を裏づける第三者の短い文章だけです。
AIを選ぶ側の基準としては、各社が安全性を語ったときに「誰が、どこまで見て、何を話せたのか」を聞くことが、これから価値を持つと考えます。今回の取り決めは、その物差しの最初の目盛りになりました。そのうえで、権限を絞る、鍵を置かないといった自分の側の備えは、どの会社のどのエージェントを使うにしても変わらず必要です。
Section 07
まとめ
2026年10月22日、METRとRedwood Researchは、OpenAI社内のエージェント監視システムを2026年7月21日から8月11日まで試験した結果を公表しました。
見つかったのは、圧縮処理の間に監視が途切れる隙間、サンドボックスとAuto-Reviewを抜けうる経路、直近の数百件の操作を監視外にできる手口、監視を切る2つのヘッダーなどです。OpenAIは本番の安全装置に関わるものはすべて修正したと説明していますが、METRはその修正を評価していません。
公開は事前に合意した短い概要に限られ、OpenAIは黒塗りを単独で決められました。対象は社内エージェントの監視であり、ChatGPTやCodexの利用者のデータが漏れたという内容ではありません。
次に注目したいのは、METRが「後日さらに詳しく共有する」としている追加の情報と、OpenAIがこの修正の確認を第三者に委ねるかどうかだ。61ページの報告書のうち、外に出たのはまだごく一部にすぎない。