AIの値札は、ここ数年ずっと「100万トークンあたり何ドル」という形で書かれてきた。9月15日に公開された「Jev」というモデルは、その単位を10億トークンに置き換えた。10億トークンで42ドル、100万トークンに直すと0.042ドル。そのうえ出力側の課金が存在しない。
作ったのはTypeSafe AIという2年前に立ち上がった会社で、創業者のディオゴ・アルメイダ氏はChatGPTの土台になったRLHF(人間の評価を手がかりにした強化学習)の研究に関わった元OpenAIの研究者である。公開から4日が経ち、外部の検証結果がいくつか出そろってきた。数字は派手だが、そのまま受け取ると判断を誤る種類の派手さでもある。
⚠ 情報の鮮度について
一次情報はTypeSafe AI公式ブログ(2026年9月15日)で、本記事公開時点で約92時間が経過しています。速報ではなく、公開後に出てきた外部検証まで含めた意味づけとして整理しました。価格・仕様はすべて2026年9月19日時点で公式ドキュメントを確認した値です。Jevは開発者向けのAPIであり、ChatGPTやGeminiの月額プランの話ではありません。
Section 01
Jevとは何か──文章の代わりに確率を返すAI
ふだん使うAIは、聞いたことに文章で答える。Jevは文章を1文字も返さない。返すのは、あらかじめこちらが定義した選択肢のどれに当たるかという確率だけだ。TypeSafeはこれを「System One Model(システムワン・モデル)」と呼んでいる。心理学者ダニエル・カーネマンの言う、速くて直感的な思考のほうを担う、という意味である。
質問の形は3つしかない。選択肢から1つ選ばせる「Choice」、段階のある基準で採点させる「Score」、はい・いいえの確率を返す「Noul」。たとえば問い合わせメールを渡して「この人は怒っているか」と聞けば、0.88という数字が返る。文章ではないので、そのままプログラムの条件分岐に差し込める。
ここから2つの性質が出てくる。ひとつは型を外さないこと。返る値の形が先に決まっているので、AIが想定外の文字列を返してプログラムが止まる、という事故が起きない。TypeSafeが「ハルシネーションできない」と説明しているのはこの意味で、事実関係を間違えないという意味ではない。もうひとつは速さで、公式ドキュメントは応答時間を70〜500ミリ秒としている。文章を1トークンずつ生成する必要がないぶん、待ち時間が短い。
0.042ドル
入力100万トークンあたりの単価
無料
出力トークンの課金
70〜500ms
公称の応答時間
一言でまとめると──文章を書く仕事をあきらめた代わりに、桁ひとつ分の安さと速さを手に入れたAIです。チャットの代わりにはなりませんが、プログラムの中で毎秒動き続ける「判断」の部分では、置き換えの候補になります。
Section 02
Jevの料金は100万トークン0.042ドル、出力は無料
公式ドキュメントに載っている値札は1行だけである。現行モデルjev-1.13.0の入力が10億トークンあたり42ドル(100万トークンあたり0.042ドル)、出力はゼロ。TypeSafeはブログで出力を「too cheap to meter(計測するには安すぎる)」と書いている。文章を返さない以上、出力トークンはごくわずかにしかならないからだ。
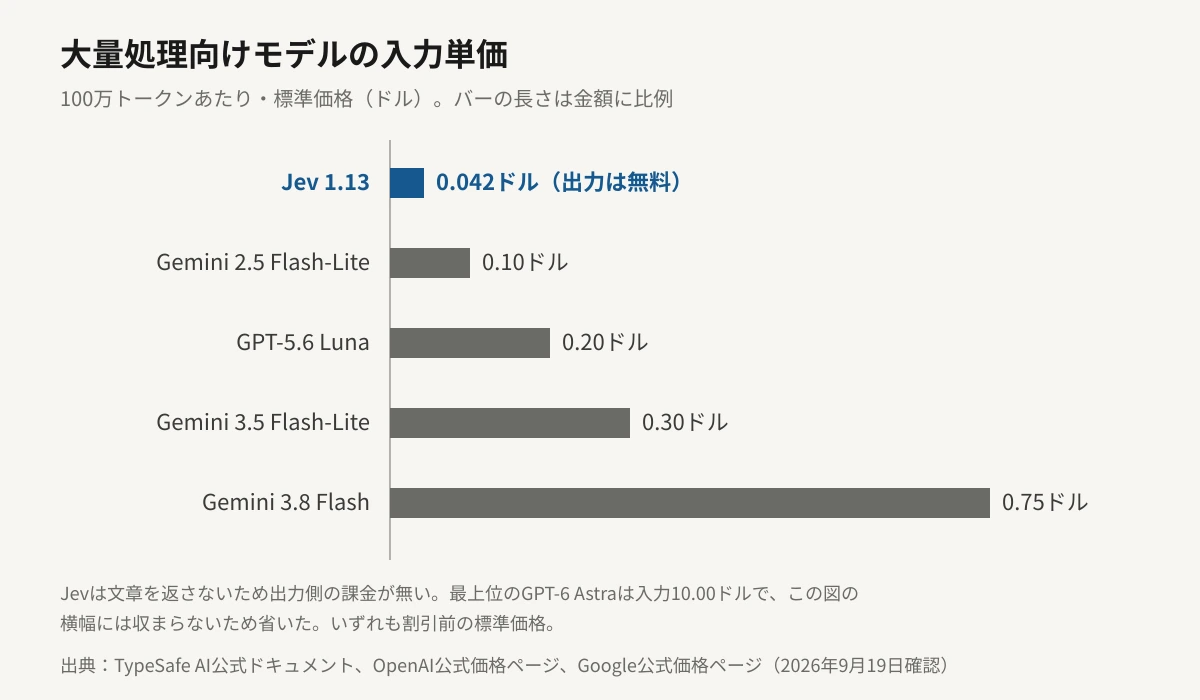
比較の相手として並べたのは、どれも大量処理に使われる安いほうのモデルだ。ChatGPTのGPT-5.6 Lunaが入力0.20ドル・出力1.20ドル、Geminiの3.5 Flash-Liteが0.30ドル・2.50ドル、2.5 Flash-Liteが0.10ドル・0.40ドルとなっている。Lunaはこの7月末に80%値下げされて今の値札になったモデルで、当時は業界の最安値を塗り替えていた(当時の記事はこちら)。そのLunaの入力単価と比べて、Jevは約4.8分の1である。
ただし、単価の表だけを見ると読み違える。価格は1つの数字ではなく、条件ごとの階層になっているからだ。
| 課金の階層 | Jev 1.13 | GPT-5.6 Luna | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| 入力(標準) | 0.042ドル | 0.20ドル | 0.30ドル |
| 出力 | 無料 | 1.20ドル | 2.50ドル |
| キャッシュ済み入力 | 割引なし(0.042ドルのまま) | 0.02ドル | 公表値なし |
| バッチ(非同期) | 割引なし | 50%引き | 0.15ドル / 1.25ドル |
| 長い入力での割増 | 割増なし(そもそも上限が64k) | 27万2,000トークン超で0.40ドル / 1.80ドル | 割増なし |
| 速度モードの別料金 | 無し | Fastは2倍 | 無し |
Lunaの割増はOpenAIのモデルページに「27万2,000トークンを超える入力は、リクエスト全体が入力2倍・出力1.5倍で課金される」と明記されている。Lunaが扱える文脈は105万トークンあるので、これは机上の条件ではない。Geminiの2つのFlash-Liteには、この種の文脈長による割増が無い。そしてJevには、割増も割引も無い。文脈の上限が64kしかないので、割増の階層を作る必要がそもそも無いからである。
Jevの値札は、良くも悪くも一枚看板だ。
Section 03
同じ0.042ドルでも、比べる相手で結論が変わる
上の表を素直に読むと、Jevが最安とは限らないことがわかる。GPT-5.6 Lunaのキャッシュ済み入力は0.02ドルで、Jevの0.042ドルの半分以下だ。同じ文脈を何度も送り直す使い方なら、Lunaのほうが安く付く区間がある。Gemini 2.5 Flash-Liteをバッチで回した場合の0.05ドルも、Jevとほぼ並ぶ。
では、どこで差が開くのか。答えは単価表の外にある。1件の判断に必要なトークン数そのものが違うからだ。LLMに判定させるときは、推論の過程や整形された出力にトークンを使う。Jevは質問を並列に評価して確率だけを返すので、同じ判断に必要な量が少なくて済む。
この差が実額として出た計測がある。開発者向け監視サービスのLangfuseが9月18日に公開したブログによれば、Good Start Labsという評価チームが6,003件の採点を同じ指示でJevと5つのLLMに行わせたところ、100万件あたりの費用はJevが160ドル、DeepSeek V4.1 Flashが260ドル、GPT-5.6 Lunaが400ドル、Gemini 3.8 Flashが1,600ドル、基準に置いたClaude Fable 5.1が33,000ドルだった。
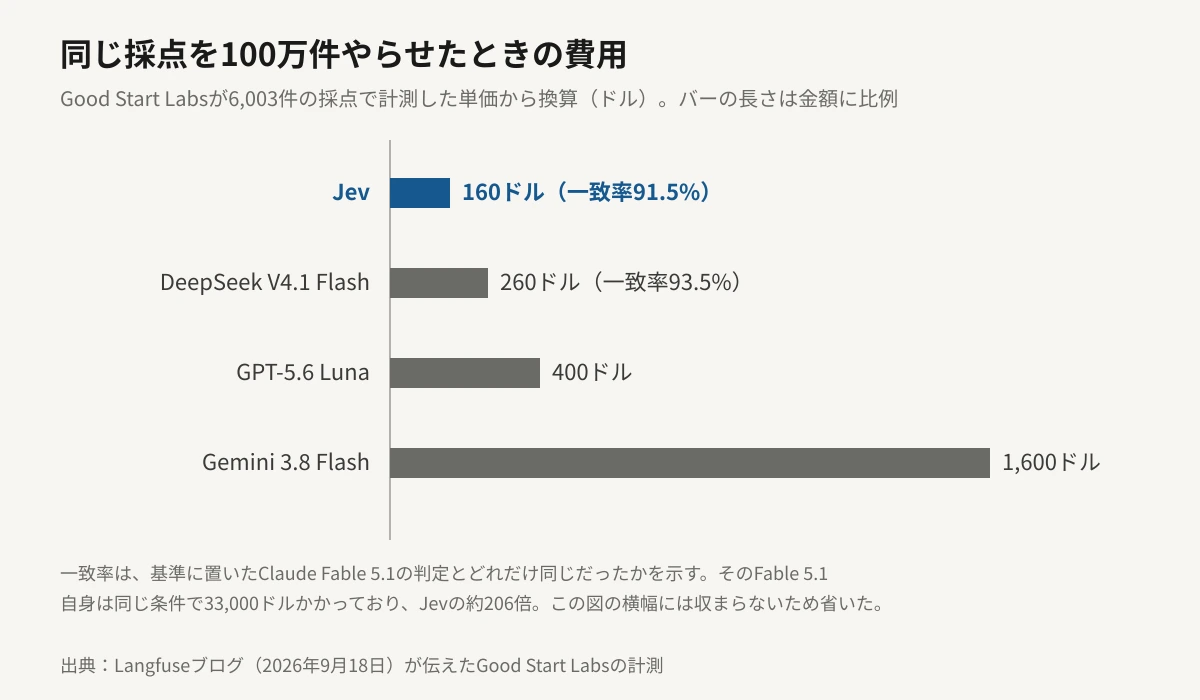
注目したいのは精度のほうだ。Jevの判定がFable 5.1と一致したのは91.5%。一方、オープンウェイトのDeepSeek V4.1 Flashは260ドルで93.5%を出している。100ドル多く払えば2ポイント上、という並びで、ここでは一方的な勝ちになっていない。
ⓘ 「桁が違う」のはどこと比べたときか
TypeSafeは自社サイトで最大193.6倍速く、444.6倍安いと掲げています。これは同社が用意した業務ワークフローの評価によるもので、比較の基準はGPT-6 AstraとClaude Fable 5.1の平均です。同社自身が「これらのワークフローは自社のモデル能力チームが作ったものなので、偏りがある可能性はある」と注記しており、第三者による再現はまだありません(※観測)。上の33,000ドルという数字が示すとおり、最上位モデルを基準に取れば倍率は大きく出ます。比べる相手を最安帯のモデルにすると、差は数倍まで縮みます。
Section 04
現場では何が置き換わったのか
公開から数日のあいだに、実際に差し替えてみた報告がいくつか出ている。共通しているのは、置き換わった場所が会話ではなく、プログラムの中の分岐だという点だ。
01
コマンドの安全判定(Vercel)
実行してよいコマンドかを判定する仕組みにGPT-5.6 Lunaを使っていたが、Jevに差し替えたところ5〜18倍速くなり、正確さも上がったとエンジニアが述べている。TechCrunchの取材による。
02
業務メールの分類(Bryo AI)
同社のCTOがGeminiと比べたところ、正確さはGeminiがわずかに上、ただし費用は10〜20倍かかったという。確率がそのまま返る点をより高く評価していた。
03
モデルの振り分け(Classmethod)
会話の要約を4段階の難易度に仕分ける検証を9月17日に公開。40回の呼び出しで全問正解、応答時間の中央値は0.64〜0.67秒、1回あたりの費用は0.000025〜0.000027ドルだった。
3つ目の用途は、使い道として筋が通っている。「この依頼はどのモデルに回すべきか」を判定させる仕事に高いモデルを使うと、振り分けのほうが本体より高くつく。安く速い判定役が別にいれば、その矛盾が消える。同じ発想はGitHub Copilotの「Auto」やCursorの自動振り分けにも入っているが、そこで使われているのは従来型のLLMだ。
一方で、手放しの評価ばかりではない。メディアEveryで評価を担当するマイク・テイラー氏は、公開当日に37本の文章をJevに採点させた記事を出しているが、本文の冒頭で「どれだけうまく仕事をこなすのかは、まだ未解決の問いだ」と書いている。速さと安さは確かめやすく、正確さは確かめるのに時間がかかる。いま出ている数字の多くは、前者に寄っている。
補助金が入っていないことを、私たちは証明できません。この価格が持続できるかどうかは、長い目で見てもらうしかない(私たちは値段が上がるのではなく、下がると見ています)。
— TypeSafe AI公式ブログ(2026年9月15日)の記述を訳出
Section 05
使う前に確かめる4つの条件
TypeSafeは、Jevが苦手なことを列挙したページを自社ドキュメントに置いている(2026年9月17日時点の記載)。売り手が自分で弱点を9項目並べている資料は珍しく、検討するならここから読むほうが早い。日本から使う場合に影響の大きい制約を4つに絞る。
⚠ 1. 日本語は英語と同じ精度ではない
公式ドキュメントは「英語が主な学習言語で、精度がいちばん良いのも英語」と明記しています。日本語を含むCJK(中国語・日本語・韓国語)の文字も扱えるものの、同等ではないとされ、自分のデータで試してから使うよう案内されています。英語の業務データなら素直に効果が出ますが、日本語の問い合わせ文を判定させるなら、自前の検証が前提になります。
⚠ 2. 計算・日付・カウントは任せられない
公式の弱点一覧は、Jevを電卓として使わないよう明言しています。文字数や件数を数えるのは不得手で、日付は順序のある量ではなく文字列として読まれるため、どちらが先かという判定も当てになりません。数値の処理はコード側に置き、モデルには判断だけを渡す設計が要ります。
⚠ 3. 「わからない」と言えず、理由も返さない
選択肢を二択で与えると、Jevは分からない場合でも「よりましなほう」を選びます。わからないという選択肢を自分で用意しておかないと、迷った答えが確信のある答えと同じ顔で返ってきます。また、なぜその判定になったのかという説明は一切返りません。監査が要る場面や、利用者に理由を示す必要がある場面では、別途モデルを重ねることになります。
⚠ 4. 文脈の上限が64k、しかも表記が食い違っている
公式ドキュメントは1回のリクエストで64kトークン、うち状態と最も長い質問の合計で32kトークンまでと記しています。ところが中継サービスのOpenRouterの掲載ページは32Kと表示しており(編集部でも確認しました)、Langfuseのブログもこの食い違いに触れて「設計する前に確認を」と書いています。関係のない情報を状態に詰め込むほど精度が落ちるとも公式は述べており、長い履歴をそのまま投げる使い方には向きません。
💡 いま試せる経路
Jevは早期アクセスの段階で、公式の利用は順番待ちリスト経由です。ただしOpenRouterとVercel AI Gatewayでも提供されており、新しく取引先を増やさずに試すならそちらが早い、とLangfuseは案内しています。PythonとJavaScriptのSDKが用意されています。
Section 06
編集部の見立て
Editor's Opinion
今回いちばん見ておきたいのは、444.6倍という倍率ではなく、値札の単位が10億トークンになったという一点です。単位が変わるのは、そこで扱われる量が桁ごと変わったときだけです。100万トークン単位の値札は「人が読む文章をやりとりする」前提で作られていました。10億トークン単位の値札は、人が一度も読まない判断が、裏側で延々と流れ続けることを前提にしています。
読者にとっての意味は、AIの乗り換え先が増えたという話ではないと考えます。むしろ、これまで1つのモデルに任せていた仕事が、分解できるものとして見えてきた、という話です。文章を書かせる部分と、条件を判定する部分。後者だけを切り出せる人は、その部分の費用を桁で下げられます。切り出せないままだと、判定のたびに文章生成の料金を払い続けることになります。
ただし、そこに飛びつくにはまだ早いとも考えています。第三者の検証はまだ数えるほどしかなく、そのうちの1つでは、オープンウェイトのDeepSeek V4.1 Flashが100ドル高いだけで2ポイント正確でした。日本語の精度が英語と同じではないと公式が認めている点も、日本の現場では小さくありません。いま確かなのは速さと安さで、正確さについては、まだ各自が自分のデータで測るしかない段階です。
そしてもう一点。この0.042ドルという値段が何によって支えられているのかは、会社自身が答えを保留しています。安さが競争のための持ち出しなのか、構造から来ているのかは、利用が増えたあとの値札を見るまで判断できません。
Section 07
まとめ
2026年9月15日、元OpenAI研究者のディオゴ・アルメイダ氏が率いるTypeSafe AIが、文章を返さないモデル「Jev」を早期アクセスで公開しました。入力は10億トークンあたり42ドル(100万トークンあたり0.042ドル)、出力は無料です。
大量処理向けのモデルと並べると、入力単価はGPT-5.6 Lunaの0.20ドルの約4.8分の1にあたります。ただしLunaのキャッシュ済み入力0.02ドルはJevより安く、Gemini 2.5 Flash-Liteのバッチ0.05ドルもほぼ並びます。差がはっきり出るのは単価ではなく、1件の判断に要するトークン量のほうです。
Langfuseが伝えたGood Start Labsの計測では、6,003件の採点を100万件に換算した費用はJevが160ドル、GPT-5.6 Lunaが400ドル、Claude Fable 5.1が33,000ドルでした。一方で判定の一致率は、DeepSeek V4.1 Flashが260ドルで93.5%、Jevが160ドルで91.5%と、精度では並ばれています。
導入を考えるなら、公式が自ら並べた弱点のほうが重要です。日本語は英語と同等の精度ではないこと、計算・日付・件数の処理は任せられないこと、「わからない」と答えられず理由も返さないこと、文脈の上限が64kで表記に食い違いがあること。この4点は、試す前に押さえておく価値があります。
TypeSafe自身は価格について「補助金が入っていないことは証明できない」と書き、そのうえで「値段は上がるのではなく下がると見ている」と続けている。次に確認すべき一点は、順番待ちリストが開いて利用量が増えたあとも、10億トークン42ドルという表示が同じ場所に残っているかどうかだ。