AI開発の新興企業Inceptionが10月19日、新しい言語モデル「Mercury 3」を公開した。1秒あたり1,068トークンを出力できるという。Claudeの小型モデルHaiku 5.5が約240、ChatGPTの無料版の標準でもあるGPT-6 Lunaが約130とされているので、数字の上では4倍から8倍の速さになる。
ただし、この数字を測ったのはInception自身である。価格にも仕掛けがある。いま表示されている入力0.10ドル・出力0.35ドル(100万トークンあたり)は、標準価格の半額にした発売記念の値段だ。標準価格は入力0.20ドル・出力0.70ドルで、LunaやHaiku 5.5の基本単価より高い。
速いが、安くはない。この組み合わせを、どんな仕事なら引き受ける価値があるのかまで落として整理する。
⚠ 情報の鮮度について
一次情報はInceptionの2026年10月19日の発表と、翌20日のSiliconANGLE、The Decoderなどの報道です。10月24日朝の時点で、発表から約4日が経っています。速度・成績・割引価格はいずれも発表時点の公表値で、確認できた範囲では第三者機関による測定はまだ出ていません。なお、ここでいう価格は開発者向けAPIの価格で、ChatGPTやClaudeの月額プランとは別物です。
Section 01
Mercury 3とは──文字を順番に書かない「拡散型」
Mercury 3を出したInceptionは、スタンフォード大学の研究者らが立ち上げた企業だ。同社のモデルは「拡散型」と呼ばれる。ChatGPTやClaudeのような一般的な言語モデルは、文章を先頭から1トークンずつ書き足していく。トークンとは、AIが文章を処理する単位のことで、日本語なら1文字が1〜2トークン前後にあたる。一方、拡散型は返答の全体をいったん下書きし、それを何度かに分けて並行して磨き上げる。SiliconANGLEはこの仕組みをそう説明している。
1文字ずつ書く方式は、長い返答ほど時間がかかる。全体を一度に直す方式なら、同じ長さでも待ち時間を縮められるという理屈である。
今回の更新で変わった点は次のとおりだ。
1,068
1秒あたりの出力トークン数(自社測定)
100万
文脈の長さ(前作Mercury 2.5は26万)
8/12
LunaとHaiku 5.5に勝った項目数(自社集計)
提供先は、Inception自身のAPI、OpenRouter、Baseten、Vercelの4つ。OpenAIのAPIと同じ書き方で呼べるので、すでにLunaを使っているプログラムなら、接続先とモデル名を差し替えるだけで試せる。新しく作ったアカウントには、1億トークン分の無料枠もある。
一言でまとめると──「待ち時間を買うAI」です。1秒あたりの出力量は競合の数倍とされますが、標準単価はLunaやHaiku 5.5より高く、その速さを測ったのもInception自身です。
Section 02
速さは4〜8倍と自称──ただし測ったのは自社
Inceptionが示した比較は、Mercury 3が毎秒1,068トークン、Claude Haiku 5.5が約240、GPT-6 Lunaが約130というものだ。割り算をすると、Haiku 5.5に対して約4.5倍、Lunaに対して約8.2倍になる。同社が「4〜8倍」と呼ぶ幅は、この2つの数字から来ている。
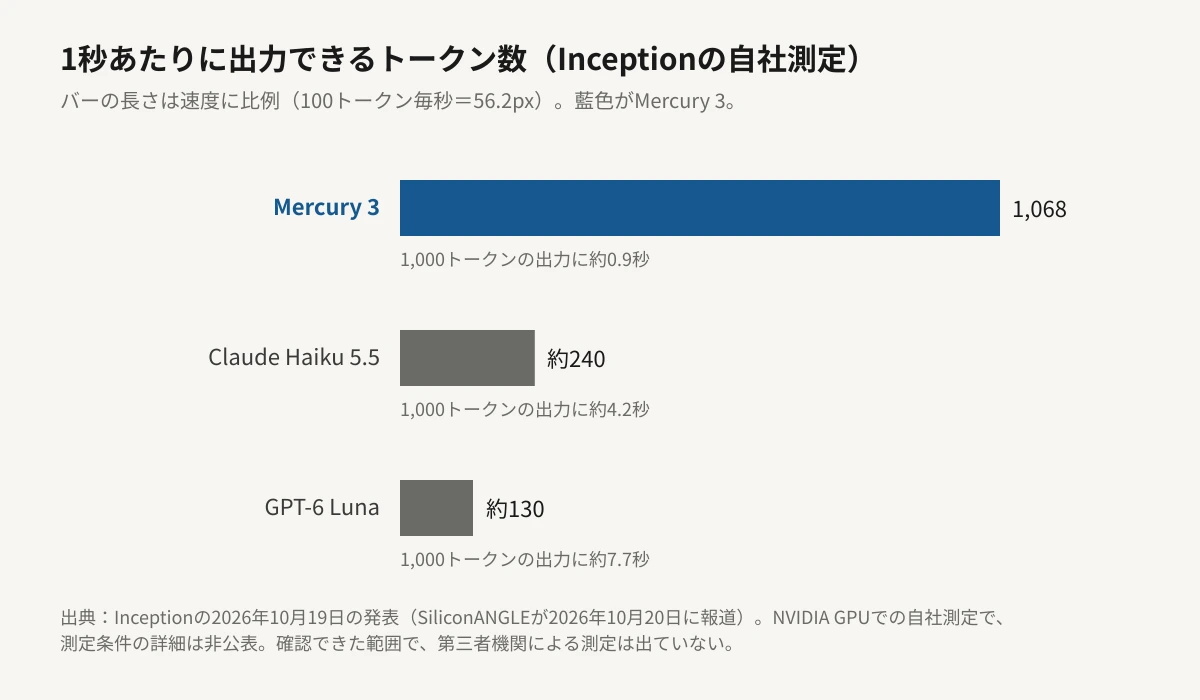
体感に直すとこうなる。500トークンほどの返答、日本語で数百字から1,000字程度の答えを、発表の数字どおりに計算すると、Mercury 3は約0.5秒、Haiku 5.5は約2.1秒、Lunaは約3.8秒で書き終える。数秒の差は、人間が画面を見ながら待つ用途ではっきり感じる長さだ。
とはいえ、この速度は生成の部分だけを切り出した数字である。実際の応答時間には、通信や検索、前処理の時間が加わる。Inceptionが紹介した顧客のOcten AI(リアルタイム検索の新興企業)の報告では、生成にかかる時間の中央値が0.9秒、応答が返るまでの全体の中央値が2.2秒だった。生成が速くなっても、全体の待ち時間はその分だけ縮むわけではない。
ⓘ 「自社測定」の読み方
速度の比較はNVIDIA製GPUでの測定とされていますが、バッチの大きさや推論の強さの設定、1人分の速度なのか全体の処理量なのかといった条件は、確認できた範囲では公表されていません。同じ速度表示でも測り方で数字は動くので、手元の用途で測り直すまでは「競合より速い可能性が高い」程度に受け止めておくのが安全です。
Section 03
Mercury 3の料金──標準単価はLunaとHaiku 5.5より高い
料金を並べる。単位はすべて100万トークンあたり、米ドルである。
| モデル | 入力 | 出力 | 長い入力のときの単価 |
|---|---|---|---|
| Mercury 3(標準価格) | 0.20ドル | 0.70ドル | 段差の記載は確認できず |
| Mercury 3(発売記念・半額) | 0.10ドル | 0.35ドル | 終了日は未公表 |
| GPT-6 Luna | 0.10ドル | 0.50ドル | 入力27万2,000トークン超で入力0.20ドル・出力0.75ドル |
| Claude Haiku 5.5 | 0.10ドル | 0.50ドル | 入力10万トークン超で入力0.50ドル・出力2.50ドル |
半額の値段だけを見ると、出力はMercury 3のほうが0.15ドル安い。標準価格に戻ると、入力も出力もLunaとHaiku 5.5を上回る。割引がいつまで続くのかをInceptionは述べていないので、予算を組むときの基準は標準価格のほうに置くのが現実的だ。
1つ、月の費用で試算してみる。1か月に1万回呼び出し、1回あたり入力2,000トークン・出力500トークンの仕事を想定する。合計では、入力が2,000万トークン、出力が500万トークンになる。
| モデル | 入力の費用 | 出力の費用 | 月の合計 |
|---|---|---|---|
| Mercury 3(標準価格) | 4.00ドル | 3.50ドル | 7.50ドル |
| Mercury 3(半額) | 2.00ドル | 1.75ドル | 3.75ドル |
| GPT-6 Luna | 2.00ドル | 2.50ドル | 4.50ドル |
| Claude Haiku 5.5 | 2.00ドル | 2.50ドル | 4.50ドル |
金額そのものは小さい。ただ、標準価格のMercury 3は、LunaとHaiku 5.5より月3ドル高く、割引中なら0.75ドル安い。この試算は編集部が公表単価から計算したもので、キャッシュ(同じ入力の使い回し)の割引は含めていない。
💡 比べ方のコツ
速さと値段は、同じ表では比べにくいものです。「1回の返答でユーザーを何秒待たせたくないか」を先に決め、その秒数を満たせるモデルの中で費用を比べると、判断が早くなります。待たせてよい仕事なら、速さの代金は払わなくて済みます。
Section 04
成績表は12項目中8項目で上──負けた項目も載っている
Inceptionは12の評価項目でLunaとHaiku 5.5と比べ、8項目でMercury 3が上回ったとしている。最も差が開いたのはコード修正の評価SWE-Bench Atlasで、Mercury 3が51.1点、Lunaが33.3点、Haiku 5.5が32.3点だった。
一方、同じ報道では負けた項目も挙げられている。コードの評価DeepSWEではHaiku 5.5が51.6点でMercury 3の46.3点を上回り、長い文書から情報を探す評価でもHaiku 5.5が勝った。Lunaは別の2項目で、1点未満の差でMercury 3を上回っている。
01
測ったのは作った本人
12項目の選び方も設定もInceptionが決めている。確認できた範囲では、第三者機関が測り直した結果は出ていない。
02
勝ちは「項目の数」で語られている
12項目中8項目という数え方は、差が1点未満の項目も、30点以上開いた項目も1勝として数える。差の大きさは項目ごとに見る必要がある。
03
パラメータ数は未公開
大きさは「初代Mercuryの40倍超」としか示されていない。性能が上がった理由を、外から確かめる材料は少ない。
Section 05
どんな仕事なら試す価値があるか
ここまでの材料で、読者のタイプ別に整理する。
A
ChatGPTやClaudeをチャットで使う人:関係しない
Mercury 3は開発者向けのAPIで提供されるモデルで、ChatGPTやClaudeの月額プランの中から選べるものではない。月額の料金も動いていない。
B
待ち時間が価値になるプログラムを作る人:試す価値がある
音声での受け答え、検索結果の要約を画面に出すまで、入力の途中で候補を出す機能など、ユーザーが画面の前で待つ仕事は、生成が数秒縮むだけで使い心地が変わる。Octen AIの事例はこの型にあたる。
C
夜間や一括で大量に処理する人:LunaとHaiku 5.5のほうが安い
誰も待っていない仕事なら、速さは請求書に載らない価値になる。標準価格で比べると、LunaとHaiku 5.5のほうが安い。
⚠ 乗り換える前に確かめること
成績表はInception自身の測定なので、移す前に自分の仕事の入力を20〜30件ほど流し、速さと答えの質を現在のモデルと並べて見ることをおすすめします。無料枠の1億トークンがあるので、費用をかけずに試せます。割引価格が終わった後の請求も、標準価格の0.20ドル・0.70ドルで試算しておくと安全です。
10月7日にはAnthropicがHaiku 5.5を、9月にはOpenAIがGPT-6 Sol・Lunaを出している。詳しくはClaude Haiku 5.5の価格の階段を読み解いた記事と、GPT-6 Sol・Lunaの値下げを整理した記事にまとめた。小型モデルの値札がほぼ横並びになったところへ、Mercury 3は価格ではなく速さで割り込んだ形だ。
Section 06
編集部の見立て
Editor's Opinion
今回の発表でいちばん面白いのは、競争の軸が変わったことだと考えます。小型モデルは、この数か月、単価の引き下げ合戦をしてきました。LunaとHaiku 5.5が入力0.10ドル・出力0.50ドルで並んだところへ、Mercury 3は「同じ値段帯のまま、待ち時間を数分の1にする」という別の売り方で入ってきました。
ただ、速度の数字は、そのまま信じるには条件が足りません。測定条件が示されておらず、割引価格の終了日も分かりません。前作Mercury 2.5のときも、速度は自社発表の数字で出ていました。今回も同じ構図なので、第三者の測定が出るまでは、請求書より先に自分の画面で確かめたいところです。
速さは、使ってみて初めて価値が分かる性能です。そして試すコストは、無料枠のおかげで小さくなっています。標準価格が割高でも、待ち時間が売り上げに響く仕事を持っている人にとっては、確かめてみる価値のある選択肢だと見ています。逆に、待たせて困らない仕事を持つ人は、いまのモデルのままで困りません。
Section 07
まとめ
2026年10月19日、Inceptionが拡散型の言語モデルMercury 3を公開しました。1秒あたり1,068トークンの出力は、Claude Haiku 5.5の約240、GPT-6 Lunaの約130より速いとされていますが、測ったのはInception自身です。
標準価格は入力0.20ドル・出力0.70ドル(100万トークンあたり)で、LunaとHaiku 5.5の基本単価である入力0.10ドル・出力0.50ドルより高くなっています。いまの入力0.10ドル・出力0.35ドルは、終了日が示されていない発売記念の半額です。
成績表は12項目中8項目でLunaとHaiku 5.5を上回りますが、DeepSWEなどでは負けており、第三者の測定は確認できていません。ChatGPTやClaudeの月額プランから選べるものではなく、開発者向けのAPIで提供されます。
次に確かめたいのは2点ある。割引価格の終了日が示されるかどうかと、Artificial Analysisのような第三者の測定でも毎秒1,000トークン級の数字が再現されるかどうかだ。