Metaが10月12日、新しいAIモデル「Muse Wonder」と「Muse Wonder Full」を公開した。開発者向けAPIで使えるのは標準のWonderだけで、価格は100万トークンあたり入力4ドル・出力20ドル。Claudeの最上位Opus 5.5と、同じ数字である。
上位のWonder Fullには、APIの値札が付いていない。使えるのは、コーディングAI「Muse Code」の月額プランに入った人だけだ。VentureBeatによれば、Powerが月50ドル、Maximumが月200ドルである。
⚠ 情報の鮮度について
一次情報はMetaの公式発表と開発者向けブログ(いずれも2026年10月12日)、同日のVentureBeatの報道です。発表から1日以内の速報にあたります。ベンチマークの数字はMeta自身が出した比較表と、独立測定機関Artificial Analysisの公開ページを分けて記しています。価格は10月13日朝に確認した公表値です。
Section 01
Muse Wonderとは──2モデルと入口の違い
MetaのAI研究部門Meta Superintelligence Labsが作った、文章・画像・音声・動画を入力できる新モデル群だ。出力は文章で、1回に読める量(コンテキスト)は約100万トークン。モデルの中身は公開されておらず、ダウンロードして自前で動かすことはできない。Metaが8月に無料公開したMuse Glimmerのような軽量版とは別の、有料の大型モデルという位置づけである。
名前が似ていて紛らわしいので、入口の違いを先に表にしておく。
| 項目 | Muse Wonder(標準) | Muse Wonder Full(上位) |
|---|---|---|
| API(従量課金) | あり | なし(価格も未発表) |
| Muse Code | 使える | PowerまたはMaximumのプラン |
| API単価(100万トークン) | 入力4.00ドル/出力20.00ドル | なし |
| 独立測定の知能指数 | 52 | 56 |
なお、Metaの個人向けアプリ「Muse」へWonderを載せるのはこれからで、Metaは「まもなく」としたうえで、有料の契約者から順に広げるとしている。いま触れる入口は、APIとMuse Codeの2つだけだ。
一言でまとめると──「値札はOpus 5.5と並べ、最上位だけは月額プランの中に置いた」。APIで比べられるのは標準のWonderまでで、Wonder Fullは契約しないと試せません。
Section 02
Muse Wonderの料金──Opus 5.5と同額、請求は2割ほど安い
Muse Wonderの標準価格は入力4.00ドル・出力20.00ドル、キャッシュ済みの入力は0.20ドル(いずれも100万トークンあたり)。Artificial Analysisの価格表では、Claude Opus 5.5も入力4.00ドル・出力20.00ドルで、単価は完全に同じだ。Wonderは入力の長さによる割増がなく、どれだけ長い文脈を渡しても同じ単価だとVentureBeatは伝えている。
単価が同じなら請求も同じか、というと違う。Artificial Analysisが知能指数の問題一式を解かせたとき、Wonderが書いた出力は1.3億トークン、Opus 5.5は2.6億トークンだった。1タスクあたりに直すと、Wonderが4.52ドル、Opus 5.5が5.98ドルで、Wonderが約24%安い。
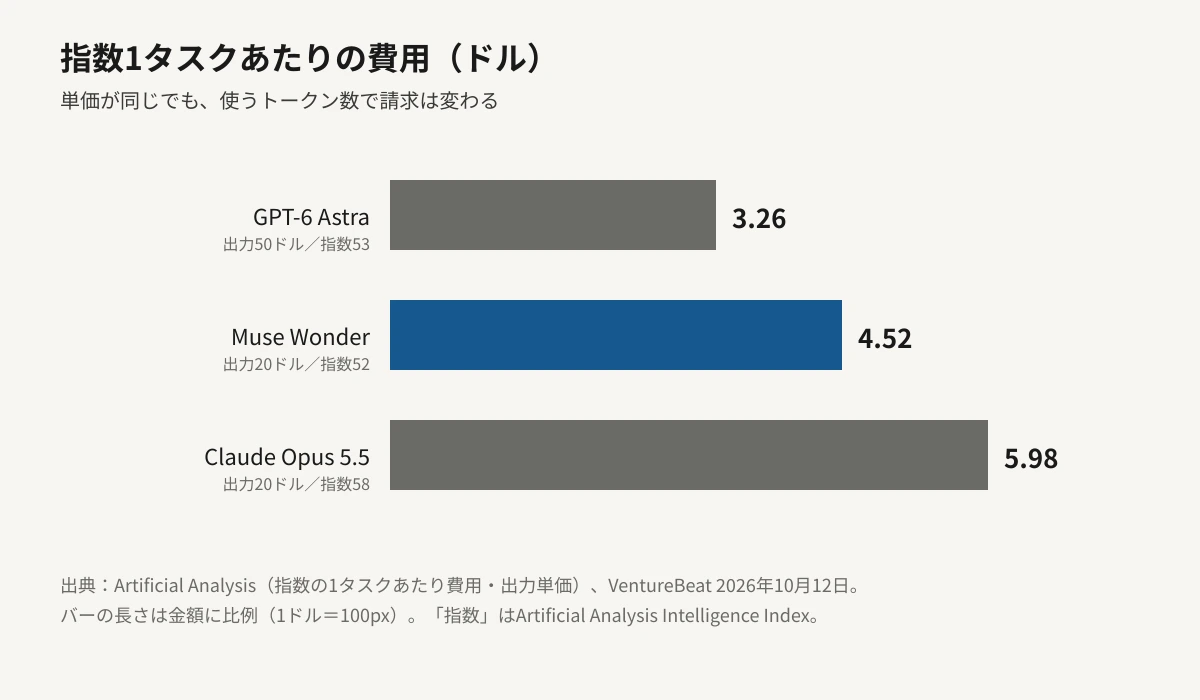
図でもう一つ目を引くのは、GPT-6 Astraの位置だ。出力単価は50ドルでWonderの2.5倍なのに、1タスクの費用は3.26ドルとWonderより安い。出力するトークン数が6,000万と、Wonderの半分以下だからである。単価の表だけを見て選ぶと、請求書の順位が入れ替わることが、この3社の間で実際に起きている。
52 / 58
知能指数 Wonder / Opus 5.5
4.52ドル
Wonderの指数1タスクあたり費用
約24%
Opus 5.5(5.98ドル)より安い幅
ただし、安いぶん点数も低い。知能指数はOpus 5.5の58に対してWonderは52で、6点の差がある。Opus 5.5の詳しい性格は前回の記事で書いたとおり、複雑な仕事ほど出力が膨らむ点にあった。今回のWonderの「安さ」は、その膨らみ方が小さいことから来ている。
Section 03
成績表を読む──勝つ行と負ける行
Metaは自社の比較表で、コーディング系の試験でWonder Fullが首位に立つ行を並べた。抜粋すると次のとおりになる。数字は最大の思考設定での得点(Wonder FullのSWE-Marathonだけはxhigh設定)で、Meta自身が掲載した表である。
| 試験(Metaの比較表) | Wonder Full | Wonder | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|
| DeepSWE 1.1(長い開発作業) | 79.0 | 78.8 | 74.1 | 74.2 |
| SWE-Marathon(超長時間の開発) | 57.5 | 53.1 | 42.5 | 46.3 |
| Terminal-Bench 4.0-AA(端末操作) | 57.1 | 52.0 | 59.1 | 59.6 |
| ProgramBench(ゼロから作る) | 59.0 | 50.0 | 52.5 | 70.5 |
長い作業を続ける試験(DeepSWE、SWE-Marathon)ではWonder系が上、端末操作とゼロからの制作ではOpus 5.5が上という割れ方だ。しかも最後の2行では、安いほうのWonderはAstraにも届いていない。VentureBeatは、この表にはMeta自身が実行した試験と第三者の試験が混ざっており、別々の試験の得点を直接比べてはいけないと注記している。いまの時点で第三者がそろって再現した結果ではなく、あくまで発表側の成績表として読むのが妥当だ。
Section 04
サブスクの既定は「学習に使われる」側
VentureBeatによると、Metaの規約にはデータの扱いが2種類ある。従量課金のAPIは「標準モード」のみで、送った内容はモデルの学習に使わない。一方、Muse Codeの月額プランの既定は「Contributor(貢献者)モード」で、プロンプト、コード、ファイル、出力をMetaが今後のモデルの改良に使えるとされる。オフにはできるが、反映されるのは以降の送信分だけだ。社外秘や個人情報を入れないよう、規約自体が求めている。
⚠ Wonder Fullを試すなら先に設定を見てください
Wonder Fullに触れる唯一の入口が、この既定のモードを持つMuse Codeです。会社のコードや顧客データを流す前に、設定でContributorモードをオフにできるか、オフにした場合に使える機能が変わらないかを確認してください。このモードは8月のMuse Code公開時から続く仕組みで、詳しくはMuse Codeのデータ提供の記事にまとめています。
Section 05
ChatGPT・Claudeを使う人はどうするか
日常の作業でChatGPTやClaudeの月額プランを使っている人にとって、今日の発表で乗り換える理由は見当たらない。Wonderの個人向けアプリへの搭載は未定で、触れるのは開発者向けの入口に限られるからだ。
A
APIでOpus 5.5を使っている人
単価は同じなので、乗り換えの損得は「自分の仕事で出力が何トークンになるか」で決まる。社内の定型タスクを20〜30件、WonderとOpus 5.5に同じ条件で流し、請求額と出来を並べるのが早い。OpenAIのSDKを使った既存のコードは、接続先とモデル名を変えるだけで試せるとMetaは説明している。
B
長い開発作業を任せている人
DeepSWEやSWE-Marathonで上位という結果は、この用途の人に関係する。ただしMetaの比較表であり、自分のコードベースで再現するかは別の話だ。Wonder FullはPower以上のプランに入らないと試せない。
C
機密を扱う人
従量課金のAPIは学習に使われない標準モード固定なので、機密に近い用途で試すならこちらを選ぶ。Wonder Fullだけはサブスクの既定が学習に使われる側になる。
Section 06
編集部の見立て
Editor's Opinion
今回いちばん気になったのは性能よりも、値札の置き方です。9月までのMetaは、安さと無料枠で入ってくる会社でした。今回は逆に、最上位クラスと同じ入力4ドル・出力20ドルを自分から名乗っています。価格で選ばれる立場から、成績で比べられる立場へ移ったということです。
そのうえで、Metaが前面に出すWonder Fullを従量課金ではなくサブスクの中に置いたのは、比べにくくする効果があります。APIで同じ条件の勝負ができるのは標準のWonderまでで、そのWonderはOpus 5.5に指数で6点届いていません。Metaが示す強みの多くはWonder Fullの数字ですから、読者は「契約してから確かめる」順番を強いられます。
一方で、1タスクあたりの費用がOpus 5.5より安いという事実は、単価表だけを見ていては出てきません。モデルを比べるときは単価ではなく、自分の仕事を1件流したときの請求額で見る。今回の3社の並びは、その癖をつける良い材料になります。
Section 07
まとめ
Metaが2026年10月12日に公開したMuse Wonderは、APIで入力4.00ドル・出力20.00ドル(100万トークン)。Claude Opus 5.5と同じ単価です。
独立測定の知能指数はWonderが52、Wonder Fullが56で、Opus 5.5の58に届いていません。ただし指数の問題1件あたりの費用は、Wonderが4.52ドルとOpus 5.5の5.98ドルより約24%安くなっています。
Wonder FullにはAPIがなく、Muse CodeのPowerまたはMaximumプラン(VentureBeatによれば月50ドルと月200ドル)の契約者だけが使えます。このプランの既定は、送った内容がMetaの学習に使われうるContributorモードです。
Metaは、Wonderの安全報告書は「まもなく公開する」としており、個人向けアプリへの搭載もまだ先です。次に確かめるのは、この報告書がWonder Fullのサイバー・自律行動のリスクをどこまで数字で示すかです。