米国のAIスタートアップRecursiveが10月21日(米国時間)、初のモデル「Flint」を公開した。重みと呼ばれる学習済みの中身そのものを、Hugging Faceで誰でもダウンロードできる。ライセンスは自由な利用と改変を認めるApache 2.0だ。
売り文句は「手元のノートPCで、コードを外に出さずに動かせるコーディング専用モデル」である。総パラメータ数は約398億個(39.8B)だが、1語を処理するときに動くのはそのうち約25億個(2.5B)だけ。4ビットに圧縮した版の配布サイズは23GBで、メモリ48GBのMacで動かした記者の試用も報じられている。
ただし、成績表も速度も、いまのところすべてRecursive自身が出した数字だ。ClaudeやCursor、GitHub Copilotを月額で使っている人にとって、これは「乗り換えの合図」なのか、「選択肢が1つ増えた」だけなのか。公開された資料の範囲で線を引く。
⚠ 情報の鮮度について
一次情報はRecursiveの公式告知(2026年10月21日、米国時間)とHugging Faceのモデルカード、および同日のTechCrunchの報道です。公開時点で約30時間が経過しています。成績・速度の数字はRecursiveが自社で測った値で、第三者による再現はまだ確認できていません。数字の単位は、Bが10億個、GBがメモリや保存容量の大きさを表します。
Section 01
Recursive Flintとは──公開されたものと数字
Recursiveは2025年に創業した会社で、「自分自身を改良し続けるAI」を目標に掲げている。CEOはセールスフォースの元チーフサイエンティスト、リチャード・ソーチャー氏。今年5月に6億5,000万ドルの資金調達と、評価額46億5,000万ドルを明らかにして表舞台に出た。Flintは、その会社が出した最初のモデルだ。
仕組みは「MoE(専門家の混合)」と呼ばれる型である。モデルの中に256個の「専門家」と呼ぶ小さな部門を持ち、1語を処理するたびに、そのうち6個と常時動く共有の1個だけを使う。持っている知識の量は大きいまま、1回に動かす量を絞る設計だ。文脈(一度に読み込める長さ)は、モデルカードでは262,144トークン。告知ページは最大51万2,000トークンとしつつ、25万6,000トークン以内を勧めている。
39.8B
総パラメータ数(約398億個)
2.5B
1語ごとに動く量(約25億個)
23GB
Ollama配布の4ビット版の大きさ
配布の入口は広い。llama.cpp、Ollama、LM Studio、vLLM、SGLangといった主要な実行環境に、公開初日から対応している。Apple Silicon向けにはRecursive自身が作った実行エンジン「rec」も出ている。
一言でまとめると──「大きな知識は残したまま、1回に動かす部分を全体の約6%に絞ったので、ノートPCに載る」。ただし性能の数字はRecursiveの自己申告で、第三者の測定はまだありません。
Section 02
ノートPCに載る理由──400億のうち動くのは25億
動く量が約25億個というのは、総数の約6%にあたる(2.5÷39.8)。計算の量が小さいので速く、メモリに置くのは全体の重みだけで済む。Recursiveの測定では、M4 ProチップのMacBook Proで毎秒125トークン超、64GBのNVIDIA RTX Sparkで毎秒150トークン超。いずれもプロンプトの読み込み時間を除いた値で、短い文脈での測定とされている。TechCrunchはM4 Proで約131トークンと報じ、比較対象のGoogle Gemma 4やNvidia Nemotron 3.5 Lightningなど似た規模のモデルは58〜69トークンだったとしている。
置き場所の小ささは、先週の話題と並べると際立つ。Metaが10月15日に重みを公開したMuse Spark Openは816B級で、Metaが示した動作構成は512GBのMac Studio 2台、合計1,024GBだった。Flintの4ビット版23GBは、この構成の合計容量に対して約45分の1にあたる(Muse Spark Open側の重みそのものは、これより小さい)。
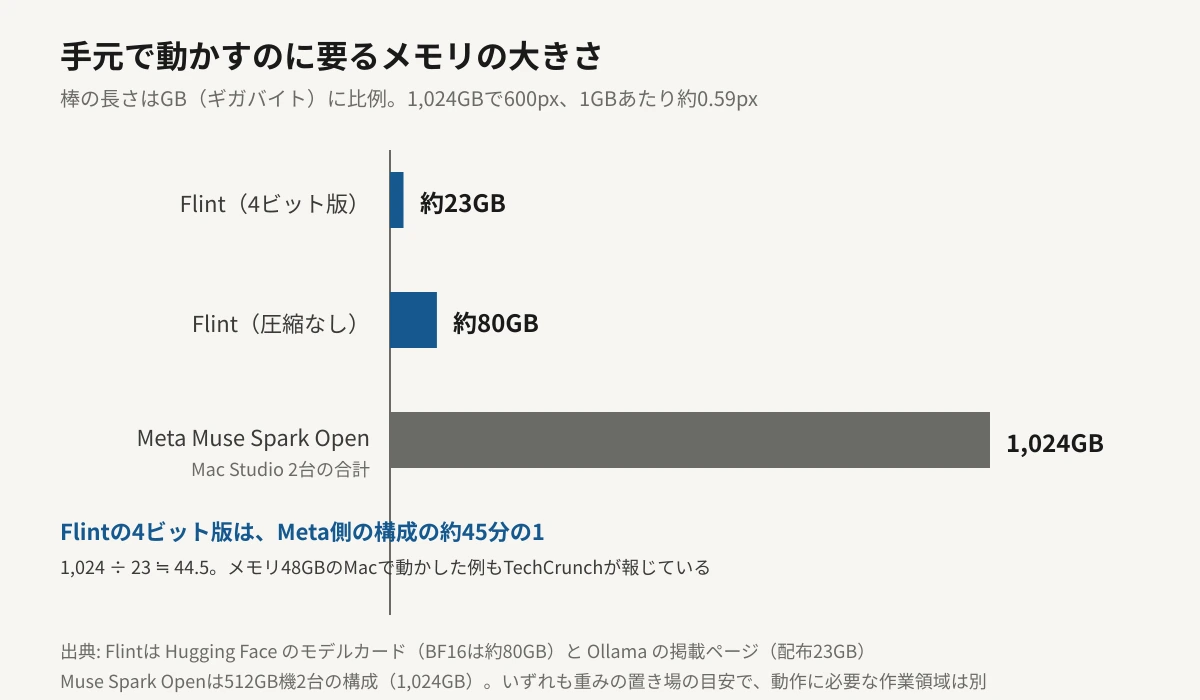
4ビット化の工夫も、この軽さの一因だ。Recursiveによると、モデルの最終出力を決める層まで4ビットに落とし、失われた精度は蒸留(大きな元のモデルを先生にして学び直させる手法)で取り戻した。16ビットの元のモデルとの差は、試験全体で0.7点以内だという。TechCrunchはソーチャー氏の投稿として、低ビット化でモデルの大きさが71%縮んだと伝えている。モデルカードの圧縮なし版(約80GB)から23GBへの変化と、数字は合う。
ⓘ 23GBは「重みの置き場」の大きさです
グラフの数字は、重みを置くのに要る容量の目安です。実際に動かすときは、長い文脈を扱う作業領域などが別に要ります。Ollamaの掲載ページには必要メモリが書かれていません。確認できている実績は、48GBのMac(Wired記者の試用)と、64GBのRTX Spark(Recursiveの測定)の2つです。
Section 03
成績表は自己申告──3つの数字の読み方
Hugging Faceのモデルカードが載せている代表的な成績は3つ。どれも、5回以上の試行の平均(1回で解けた割合)である。
| 試験 | Flintの点数 | 測り方(モデルカードより) |
|---|---|---|
| Terminal-Bench 2.1 | 54.9% | Terminus 2を使用。ネット接続あり。検索で取得した解答は失敗扱い |
| SWE-bench Pro v2 | 89.7% | mini-swe-agentを使用。ネット接続なし |
| SWE-bench Verified | 74.2% | mini-swe-agentを使用。ネット接続なし |
読み方の注意が3つある。1つ目は、試験ごとに問題集が別なので、点の高低を横に並べて難しさを比べられないこと。Pro v2の89.7%がVerifiedの74.2%より高いからといって、Pro v2のほうが易しいとは限らない。
2つ目は、比較相手の選び方だ。Recursiveが「勝った」と言っているのは、総パラメータ50B未満のMoE型モデルに対してで、TechCrunchによれば、Recursiveが出した6試験の平均でFlintを上回るのは、Alibabaの密なモデルQwen3.8 27Bだけだ。
3つ目は、速度の測り方である。Recursiveの測定は短い文脈での値で、プロンプトを読み込む時間は含まない。長いコードベースを読ませる場面で同じ速さが出るとは限らない。
Section 04
「AIが開発を担った」の中身
Recursiveは、Flintを「4か月足らずで、少人数のチームと自社の研究システム『Eureka Machine』で一から作った」と説明している。このシステムは、案を出し、実験を回し、結果を見て次の実験を決める。人の研究者がやる流れを、AIの側で回す仕組みだ。
具体的に何をしたのか。公開されている説明では、3つの場面が挙がっている。
01
設計の絞り込み
出発点は総35B・動く量3Bの設計。専門家の数や幅を変えて試し、速さとコーディング性能の釣り合いが最も良かった40B・2.5Bに落ち着いた。
02
4ビット化の学習手順
出力層まで4ビットにするのは一般的なやり方に反する。蒸留の段階を足して精度を取り戻し、従来の方法に比べて学習の手数を約半分にしたという。
03
専用の計算プログラム
AppleのM4・M5向けに、1語を作る処理全体を1つにまとめるMetalの「メガカーネル」を、NVIDIAのRTX Spark向けにも専用のカーネルを作った。
ただし、これは「AIがAIを改良し続ける」ことの証明とは別の話だ。The Decoderが指摘するとおり、Flintを作ったEureka Machineが、そのおかげで研究者として実際にうまくなった、という循環はまだ示されていない。TechCrunchによれば、Recursiveは研究者の時間をどれだけ節約できたかも明らかにしていない。
Section 05
あなたの開発環境で何が変わるか
A
TechCrunchによれば、Recursive自身が、大型の有料コーディング支援より多くの手引きが要ると認め、大きな作業は小さく分けるよう勧めている。Wired記者は48GBのMacで、ToDoアプリとWeb調査ツールを作らせ、すべての依頼を正しく処理したと報じられた。一方で記者は、小型モデルは一般にClaudeやCodexと比べて誤りや遅さが目立つとも述べている。定額で使うコーディング支援の選び方は、GitHub Copilotの自動選択の記事で整理した。
B
コードを社外に出せない人:検討する理由がある
ローカルで動くので、コードが外部のサーバーに送られない。オフラインで使え、利用量に応じた従量課金もない。ライセンスはApache 2.0で、利用も改変も認められている。なお、ホスト型APIの規約やデータの扱いは、重みのライセンスとは別である。
C
とりあえず触ってみたい人:1行で試せる
Ollamaを入れていれば、ollama run flintで動く。Ollamaの掲載ページには、claude、opencode、hermes、openclawといったコーディングエージェントをFlintで起動するコマンドも載っている。
💡 モデルカードの推奨設定
温度1.0、top-p 0.95、top-k 20。難しい課題では、推論を含めて32,768トークン以上の出力枠を取ることが勧められています。長く考えるほど応答が遅くなり、答えが出る前に出力枠を使い切ることもある、と注意書きがあります。
⚠ 試す前に知っておくこと
モデルカードによると、Transformers向けのモデル定義コードはまだ同梱されていません。生成したコードのテストと、影響の大きい変更の確認は人の側で行う前提になっています。ツールを呼び出す用途では、実行の許可範囲を自前で決める必要があります。
Section 06
編集部の見立て
Editor's Opinion
Flintで注目すべきは、成績表の89.7%という数字より、23GBという大きさだと考えます。先週のMuse Spark Openは「机の上で動かせる」と言いながら、必要な構成は512GB機2台でした。同じ「手元で動かす」でも、今週のFlintの4ビット版は、その構成の合計容量の約45分の1です。手元で動かす、という言葉の指す範囲が、1週間で大きく動きました。
とはいえ、数字はまだRecursiveの手のひらの上にあります。成績も速度も、第三者が同じ条件で測った結果は出ていません。とくに速度は、短い文脈での平均値です。日々のコーディングで長いファイルを読ませたときの体感は、これから出てくる再現報告を待つ必要があります。
「AIが開発の大半を担った」という説明も、私たちは割り引いて受け取ります。AIの助けを借りて作ること自体は、すでに他社も進めています。Recursiveが示すべきは、その助けがモデルの出来を押し上げ、さらに次の開発を速くする循環が実際に回ることです。Flintは、その最初の1周目の成果物にすぎません。
月額で使っているツールを手放す理由には、まだなりません。一方で、手元で動かす選択肢が、論文の話ではなく23GBのダウンロードになったのは事実です。
Section 07
まとめ
米RecursiveがFlintの重みをApache 2.0で公開したのは、2026年10月21日(米国時間)です。総パラメータ約398億個(39.8B)のMoE型で、1語ごとに動くのは約25億個(2.5B)。Ollama配布の4ビット版は23GB、文脈の長さはモデルカードで262,144トークンです。
代表的な成績は、Terminal-Bench 2.1が54.9%、SWE-bench Pro v2が89.7%、SWE-bench Verifiedが74.2%。速度はM4 ProのMacBook Proで毎秒125トークン超です。これらはすべてRecursive自身の測定で、第三者による再現は確認できていません。
TechCrunchによれば、Recursiveは大型の有料コーディング支援より多くの手引きが要ることを認めています。いま使っているツールの置き換えというより、コードを外に出せない人や、課金なしで試したい人に向けた選択肢が1つ増えた、という位置づけです。
確かめる点は1つだ。SWE-bench Pro v2の89.7%が、Recursive以外の手で同じ条件で測っても出るのか。独立した再現が出てくるまで、この数字は参考値にとどまる。