Metaが10月15日(米国時間)、新しいAIモデル「Muse Spark Open」の重み(学習済みの中身そのもの)を公開した。パラメータ数は合計816B、つまり8,160億個。1回の処理で実際に動くのはそのうち約420億個で、100万トークンの文脈を扱える。Metaは「米国発のオープンウェイトモデルとして、これまででもっとも高性能」と位置づけている。
話題の中心は、性能表よりも置き場所のほうだ。Metaは、Appleと組んでMac Studio 2台をつなぐだけで、このモデルを机の上で動かせる構成を示した。データセンターの設備がなくても動く、という売り方である。
ただし条件がいくつも付く。2台に必要な512GB構成のMac Studioは、Appleによれば10月下旬の提供予定でまだ買えない。ライセンスも「何でも自由」ではない。ChatGPTやClaudeを画面から使っている人にはほとんど関係のない話に見えるが、AIを選ぶ側がどこを見ればよいかは、この発表でかなりはっきりする。
⚠ 情報の鮮度について
一次情報はMetaが2026年10月15日(米国時間)に出した公式の告知です(PyTorch公式ブログ、開発者向けブログ、Hugging Faceのモデルカード)。10月16日朝の時点で、公開から1日足らずしかたっていません。成績表の数字はMeta自身が示したもので、独立した測定機関の結果はまだ確認できていません。Mac Studioの提供時期と価格はAppleの公式ページを確認しています。
Section 01
Muse Spark Openとは──重みが公開されたということ
AIモデルの「重み」とは、学習の結果として得られた膨大な数値の集まりで、モデルの頭脳にあたる部分だ。これを配布するのがオープンウェイトで、受け取った側は自分の機械にダウンロードして動かせる。ChatGPTやClaudeのように会社のサーバー経由でしか使えないモデルとは、ここが根本的に違う。
Muse Spark Openは、Metaが先に出していたMuse Sparkの重みを公開した版にあたる。Metaの説明では、公開版は誤用への耐性を高める追加の安全調整を受けている。仕組みは「混合専門家(MoE)」型で、256個ある専門パーツのうち、1トークンごとに8個だけを動かす。合計の大きさは巨大でも、毎回の計算量は420億パラメータ分で済むというのがこの方式の利点だ。
816B
総パラメータ数(8,160億個)
42B
1回の処理で動く分(420億個)
1M
文脈の長さ(100万トークン)
入力できるのは文章・画像・動画・音声で、出力は文章だ。Metaはコード生成と、複数の手順を自分で進める「エージェント」用途を主眼に置いている。入手先はHugging Faceで、申請して承認を受ける方式(ゲート付き)になっている。自前で動かさない場合は、Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AIの各サービス経由で使えるとMetaは案内している。Amazon SageMaker、Google CloudのModel Garden、MicrosoftのFoundryにも載っている。
一言でまとめると──「頭脳そのものをダウンロードして自分の管理下で動かせるモデルが、米国発でここまで大きくなった」という発表です。ただし動かすには大きな機械が要り、商用には守る条件があります。
Section 02
手元で動かすには──必要メモリとMac Studio 2台の現実
Muse Spark Openを自分の機械で動かすために、モデルカードが求める容量は、圧縮したNVFP4版で700GB以上、圧縮しないBF16版で2TBである。GPUのメモリでこの量を積むには、サーバー級の機材が何枚も要る。
そこでMetaが示したのが、AppleのMac Studioを使う方法だ。Macは、CPUとGPUが同じメモリを共有する「ユニファイドメモリ」を採用しているため、容量の大きい機種を並べると、大型モデルの置き場として使える。構成は2通りある。M5 Ultraチップで512GBを積んだMac Studio 2台、または256GBの機種4台で、どちらも合計1TBになる。台同士はThunderbolt 5とRDMAという高速な接続でつなぎ、NVFP4版をAppleのMLXで動かす。
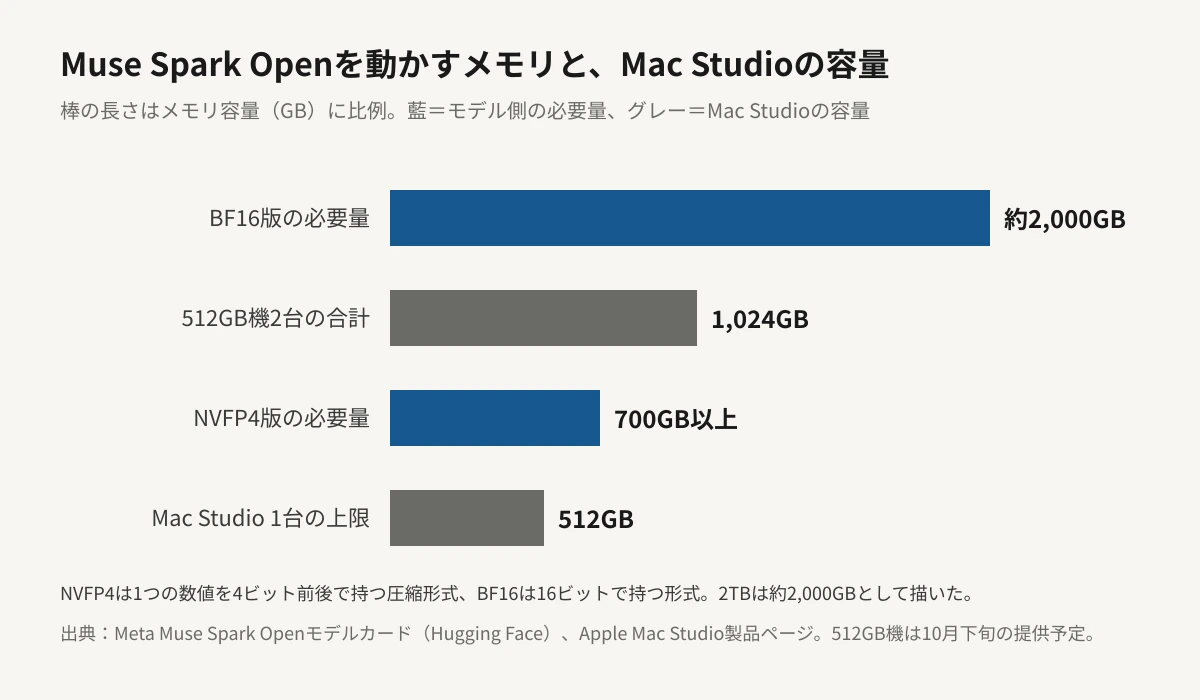
図のとおり、1台では512GBの上限に届かず、2台でちょうど700GBの要件を超える。なお、ここで問題になるのは重みだけではない。重みだけなら、816B個を4ビットで持つと約408GB、16ビットでは約1.6TBになる計算で(編集部の概算)、モデルカードの数字との差は、長い文脈を扱うための作業領域などに使われるとみられる。
⚠ 今日は買えない構成です
Appleの公式発表によれば、Mac Studio(M5 Ultra)の価格は5,499ドルからですが、512GBのメモリを積んだ構成が出るのは10月下旬とされています。512GB機の価格はAppleの発表から確認できていません。256GB機4台の構成なら512GB機を待たずに組める可能性がありますが、その費用もAppleの発表からは確認できません。
ここで見落としたくないのは、この構成が「個人の趣味の機材」ではないことだ。台数と容量を考えると、1人が使うために買うというより、社内に置いて何人かで共有する使い方が現実的である。そのかわり、入力した文章や社内資料が自分たちの機械の外へ出ない。情報を外に出せない部署にとっては、費用の大きさと引き換えにできる利点になる。
Section 03
成績表を読む──Metaの表で勝つ行と負ける行
Metaがモデルカードに載せた比較表を見ると、強みと弱みがはっきり分かれている。比較相手は、Mistral Large 4と、中国発のQwen3.8(2.4T)、GLM 5.3、Kimi K3の3つだ。ChatGPTやClaudeの最新モデルは、この表に入っていない。
| 指標(高いほど良い) | Muse Spark Open | Qwen3.8 | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|
| 知能指数(Artificial Analysis) | 39 | 40 | 45 | 44 |
| 道具の呼び出し(MCP-Atlas) | 89.2 | 84.5 | 84.2 | 82.3 |
| 端末操作(Terminal-Bench 2.1) | 76.4 | 82.0 | 83.9 | 85.0 |
| 画面操作(OSWorld Verified) | 80.4 | 表になし | 表になし | 84.8 |
| 大学院レベルの科学問題(GPQA Diamond) | 89.0 | 93.5 | 91.7 | 93.5 |
読み取れることは3つある。1つ目は、道具を呼び出して作業を進める力(MCP-Atlas)でMuse Spark Openが表の最上位に立っていること。エージェント用途を前面に出した設計と合う。2つ目は、総合の知能指数では39で、Qwen3.8の40、Kimi K3の44、GLM 5.3の45に届いていないこと。Mistral Large 4の38は1点上回る。3つ目は、コードを書いて端末を操作する試験(Terminal-Bench 2.1)では76.4と、Kimi K3の85.0に8.6点離されていることだ。
もう一点、見る側が注意したいのはこれがMeta自身の測定値だということ。知能指数の39は、独立機関のArtificial Analysisがまだ掲載していない段階の数字で、※観測として扱うのが妥当だ。表の中でMuse Spark Openは推論の深さを最大の「xhigh」に設定し、GLM 5.3とKimi K3は「max」に設定されている。設定の呼び名が違うので、点差を厳密な優劣として読むのは避けたい。
ⓘ 直近の同じ指数との並び
Mistral Large 4の知能指数38は、10月7日の記事で取り上げた数字と同じです。ただし、この指数は版が上がると同じモデルでも点数が変わるため、別の時期の数字どうしを並べるときは、同じ版で測ったものかを確かめる必要があります。
Section 04
Muse Spark Openのライセンス──自由だが外せない条件
モデルは「Muse Model License」という独自のライセンスで配布される。ライセンス本文は、使用・複製・改変・追加学習・蒸留・再配布・販売までを広く認めている。Metaは、モデルが出した出力の所有権も主張しないとしている。それでも、AIで商売をする側が読んでおくべき条件が3つある。
01
「Built with Muse Spark Open」の表示
このモデルや、それを使って作った派生モデルを使う製品・サービスは、画面か、説明書・ウェブサイト・設定メニューのどこかにこの文言を出さなければならない。派生モデルには、このモデルの出力を使って学習・蒸留したモデルも含まれる。
02
APIとして売る会社には売上の線がある
モデルをAPIなどの形で第三者に提供する事業(Model as a Service)を営み、その会社と関連会社の総売上が連続する12か月で2,000万ドルを超えるなら、Metaへの通知と別の契約が先に必要になる。社内利用、研究、自社製品の機能の一部として使うだけの場合は対象外だ。
03
利用規約と18歳未満の扱い
付属の利用ポリシーへの準拠が条件になる。モデルは18歳未満の利用を想定しておらず、そうした人に提供する場合は、リスクの評価と対策が提供者の責任とされる。
2,000万ドルの線は、モデルから得た売上ではなく会社と関連会社の総売上で判定される点に注意したい。大企業のグループ会社が外部向けにAPIを出すなら、モデルでの売上がゼロでも線を超えていれば対象になる。小さなスタートアップがAPIを出す場合は、当面は通知も契約も要らない。
Section 05
ChatGPT・Claudeを使う人はどうするか
立場によって、やることはまったく違う。
A
画面でAIを使っている人:何も変えなくてよい
ChatGPT、Claude、Geminiの月額プランに直接の影響はない。Muse Spark Openはアプリではなく部品であり、使うには誰かがサーバーに載せるか、APIで提供する必要がある。いまの料金を見直す理由にはならない。
B
社内の資料を扱いたい部署:試す価値がある
外部のAPIに文章を送れない業務では、重みが手元にあることが決め手になる。まずはOpenRouterなどの提供サービスで品質を確かめ、問題なければ自前運用の費用と比べる順番が堅実だ。512GB機が出るのは10月下旬のため、機材の発注はそれを見てからでも遅くない。
C
AIで商売をする側:ライセンスを先に読む
表示義務は派生モデルにも及ぶ。APIとして売る予定があるなら、グループ全体の売上が2,000万ドルを超えるかを先に確認する。GitHub Copilotのようなコーディング支援ツールで使えるかは、各ツールの対応を待つ必要がある。
三日前に出たMetaの上位モデルMuse Wonderは、API価格がClaude Opus 5.5と同額で、上位版は月額プラン限定だった(詳しくはMuse Wonderの記事)。今回のMuse Spark Openはその逆で、性能より「持てること」を売るモデルになっている。Wonderの重みは今回の公開に含まれないと報じられている。
Section 06
編集部の見立て
Editor's Opinion
今回の発表でいちばん面白いのは、成績表の数字ではなく、Appleとの組み方だと考えます。大型のオープンモデルは、これまでデータセンターの機材を持つ会社のものでした。Metaは「机の上に置ける」という絵を先に作りました。実際に買える人は限られますが、AIを選ぶ基準に「どこで動かせるか」が加わったのは確かです。
一方で、Meta自身の表を読む限り、総合力では中国発のオープンモデルに追いついていません。「米国発でもっとも高性能」という言い方は事実としては成り立ちますが、選ぶ側にとっての意味は小さいと見ています。国籍で選ぶ人がいる一方、多くの人は自分の仕事で結果が出るかで選ぶからです。
ライセンスの条文は、公開直後に読んでおく価値があります。表示義務が派生モデルに及ぶ点は、見落としやすい箇所です。蒸留で別のモデルを作るつもりの会社は、完成後ではなく設計の段階で確認しておくべきでしょう。
Section 07
まとめ
Metaが2026年10月15日(米国時間)、Muse Spark Openの重みを公開しました。総パラメータ816B(8,160億個)、1回の処理で動くのは約42B(420億個)、文脈は100万トークンです。
手元で動かすにはNVFP4版で700GB以上、BF16版で2TBのメモリが要ります。Metaは512GBのMac Studio 2台、または256GBの4台という構成を示しましたが、512GB機は10月下旬の提供予定です。
Meta自身の表では、道具の呼び出し(MCP-Atlas)で最上位、知能指数は39でQwen3.8・Kimi K3・GLM 5.3の後ろです。ライセンスは自由度が高い一方、「Built with Muse Spark Open」の表示と、グループ売上2,000万ドル超のAPI事業者への別契約という条件があります。
次に確かめるのは、Artificial Analysisの独立測定が知能指数39を裏づけるかどうかと、10月下旬に512GBのMac Studioが出荷されたときの価格です。この2つが出そろうまで、2台構成の費用と性能の釣り合いは判断できません。