フランスのMistral AIが10月6日、新しい旗艦モデル「Mistral Large 4」を公開した。総パラメータ数は約1兆、1回の処理で実際に動くのは490億という巨大モデルで、公開の形は「Research Public Preview」。つまり正式版ではなく、研究向けの先行公開である。
独立測定機関Artificial Analysisの知能指数は38点。これは ChatGPT の低価格モデルGPT-6 Lunaと同じ点数だ。ところが標準価格は、入力100万トークンあたり1.36ドル、出力4.18ドル。Lunaの出力0.50ドルと並べると、約8倍になる。
同じ点数で単価が8倍。それでもこのモデルに注目する理由は、点数の外側にある。サイバーセキュリティ作業を断らないこと、そして10月末に重みが公開される予定であること。この2点だ。
⚠ 情報の鮮度について
一次情報はMistral公式の発表(2026年10月6日)と、同日のArtificial Analysisによる測定結果です。公開から1日程度が経過しています。モデルは先行公開の段階で、価格・文脈長・性能は今後変わる可能性があります。価格は開発者向けAPIの公表値で、ChatGPTやClaudeの月額プランとは別物です。
Section 01
Mistral Large 4とは何が出たのか
Mistral AIは、パリに本社を置くAI企業だ。9月にはシリーズDで30億ユーロを調達しており、その資金で何を作るのかが注目されていた。Large 4は、その後に出た初の旗艦モデルにあたる。
公式の発表によると、中身は推論と通常応答を1つにまとめた「ハイブリッド」型のMoE(Mixture of Experts)である。MoEとは、巨大なモデルの内部を多数の専門家に分け、1回の処理ではそのうち一部だけを動かす方式のことで、全体は大きくても動かす計算量は小さく済む。入力は文章と画像、出力は文章だ。160を超える言語に対応し、NVIDIAのGrace Blackwell GPUを3,800基使い、Mistralの欧州内データセンターで学習したという。
約1兆
総パラメータ数(有効は490億)
38点
Artificial Analysis 知能指数
10月末
重み(モデル本体)の公開予定
一言でまとめると──「点数はLunaと並び、単価は約8倍。そのかわり、他社が断る作業を引き受け、重みが公開されれば自社で動かせる可能性がある、欧州発の先行公開モデル」です。万人向けの乗り換え先ではなく、条件の合う人だけに意味があります。
Section 02
知能指数38は、GPT-6 Lunaと同じ高さ
Artificial Analysisは、複数のベンチマークを1つの点数にまとめて、モデルどうしを並べられるようにしている測定機関だ。同社の測定でLarge 4は38点。GPT-6 Lunaの最大努力度設定(38点)と並び、DeepSeek V4.1 Flashの最大努力度設定(39点)をわずかに下回る。同社はこれを「米国と中国を除くと、最も知能の高いモデル」と位置づけた。
オープンなモデルだけで並べると8番目で、上位7つはいずれも中国発という整理も出ている。米国勢の最上位との差も残る。同社の指数で、Anthropicが9月に出したClaude Opus 5.5は58点だった。
つまりLarge 4は、「最先端に追いついた」のではなく、低価格帯の主力と並んだという位置にいる。そして低価格帯では、点数が同じなら価格が安いほうが選ばれる。
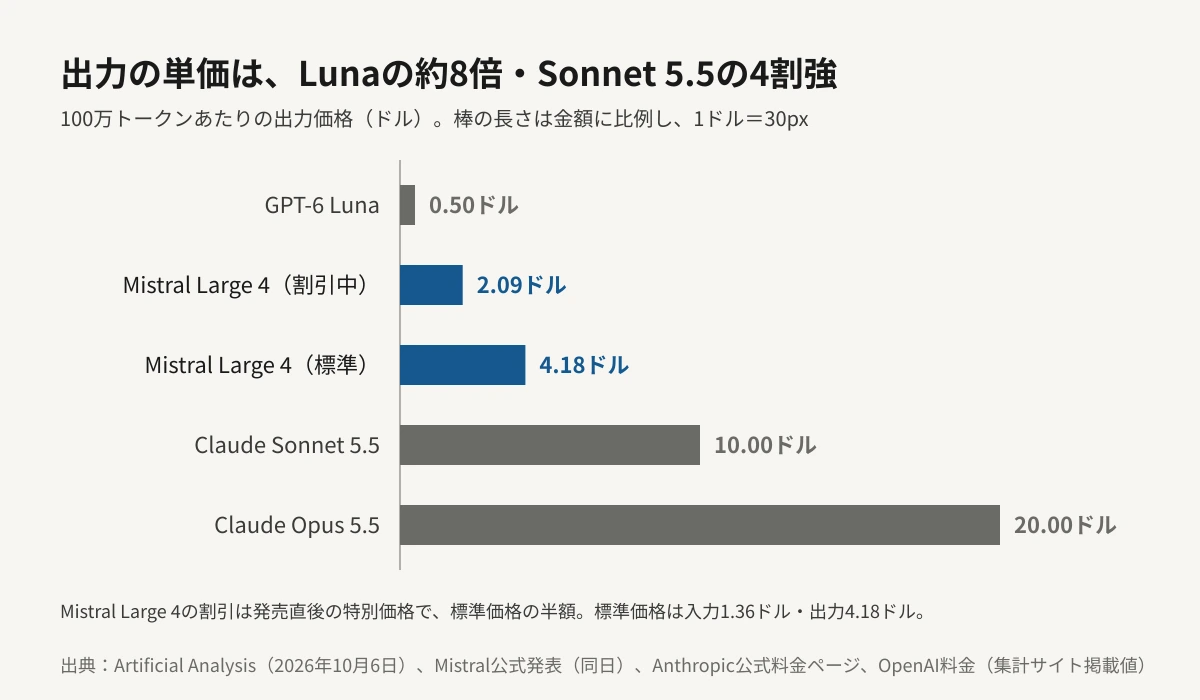
図のとおり、Large 4の標準価格はLunaより長く、Claude Sonnet 5.5(出力10.00ドル)の4割強にとどまる。価格表の上では、LunaとSonnet 5.5のあいだに割り込んだ形だ。入力側も同じ構図で、Luna 0.10ドルに対してLarge 4は1.36ドル、13.6倍になる。
Section 03
単価の差に、饒舌さが上乗せされる
トークン単価は、請求額の半分でしかない。もう半分は、同じ問題を解くのに何トークン書くかだ。Artificial Analysisが指数の全課題を解かせたところ、Large 4が出力したのは約2億トークン。同程度のモデルの中央値は8,100万トークンで、約2.5倍の量を書いている。同社はこれを「非常に饒舌」と評した。
その結果、指数の課題1つを解くための費用は標準価格で1.13ドルになった。同社は、知能が近いオープンウェイトモデルと比べて「課題あたり費用が4倍超」としている。発売直後の50%割引が適用されると、この費用は0.57ドルまで下がる。
01
単価の差
出力でLunaの約8.4倍、入力で13.6倍。ここまでは価格表を見れば分かる。
02
書く量の差
同じ課題を解くのに、同格モデルの中央値の約2.5倍のトークンを出力する。単価の差に、この倍率が掛かる。
03
割引は期間限定
半額(入力0.68ドル・出力2.09ドル)は発売直後の特別価格。期間は発売から2週間とする報道があるが、終了日の公式な記載は確認できていない。※観測
文脈長(一度に読ませられる長さ)は、資料によって数字が割れている。Mistral側の資料と一部の報道は100万トークン、Artificial Analysisや配信側の記載は50万トークン台だ。先行公開の段階で設定が動いているとみられるが、確定した値は現時点で見つかっていない。長い資料を丸ごと読ませる用途を考えているなら、契約前に公式のドキュメントで確かめたい。
Section 04
断らないモデルという売り文句
Mistralが前面に出している強みは、知能指数ではなくセキュリティ作業だ。公式の発表では、オープンソースソフトウェアの実在する脆弱性を再現して修正する課題で82%の成功率を示した。Mistralによれば、Artificial Analysisのサイバー指数で世界の上位5位に入り、中国勢を除くオープンウェイトでは首位だという。Artificial Analysis自身が示した点数は50で、中国のGLM-5.3-Flashと並ぶ。
このとき、Mistralは比較相手を名指しした。同社の説明によれば、ClaudeのOpus 5.5とGPT-6 Astraは、この課題を拒否するため得点がほぼゼロになる。
脆弱性を守る側の作業は、多くの場合「その脆弱性が本物だと証明する」ところから始まる。
— Mistral公式発表の趣旨(意訳)
これはMistral自身の説明であり、拒否の挙動について第三者が同じ条件で再現した結果は、現時点で確認できていない。※観測。ただ、方向性は理解しやすい。米国の大手モデルは、攻撃にも転用できる作業を安全策として断る傾向を強めてきた。断られる側にいる防御担当者にとって、断らないモデルは、点数が同じでも別の価値を持つ。
⚠ 「断らない」は両刃です
攻撃に使える作業を引き受けるということは、悪用にも使えるということです。Mistralは、Lakeraの攻撃耐性ベンチマーク「B3」で93.3%を防いだと説明しており、悪意ある指示を拒否する割合は他のオープンモデルより高いとされています。ただし、これも現時点では自社の公表値です。
Section 05
オープンウェイトの約束は、まだ果たされていない
オープンウェイトとは、モデルの重み(学習の成果を数値にした本体)を公開し、利用者が自分のサーバーで動かせる形のことをいう。Mistralは、Large 4の重みを10月末に公開すると発表している。ただし現時点で公開されているのはAPI経由のプレビューだけで、重みは1バイトも出ていない。
公開後のライセンス(商用利用や再配布の条件)の詳細も、重みの公開と同時に示される予定とされる。Mistralは過去のモデルで、商用利用に別契約を求めた例がある。「オープン」という言葉から、誰でも自由に商用利用できると受け取るのは早い。
そもそも約1兆パラメータのモデルは、個人のパソコンで動かせる大きさではない。重みが公開されても、実際に自前運用できるのは、データセンター級のGPUを持つ企業や研究機関に限られる。多くの人にとっての恩恵は、公開後に複数の事業者がAPIで提供を始め、価格競争が起きることのほうだろう。
Section 06
あなたの使い方では、どこが変わるか
A
ChatGPT・Claude・Geminiの月額プランの人:変わらない
今回動いたのは開発者向けAPIの価格表だけで、各社の月額プランの価格や中身は動いていない。Large 4を使うには、Mistralのコンソールか、対応する配信サービスの契約が別に要る。
B
大量処理をAPIで回している人:Lunaを替える理由は薄い
同じ38点で、単価は8倍以上、書く量も多い。分類・要約・整形のような仕事なら、Lunaのほうが請求は小さくなる。割引中でも出力2.09ドルで、Lunaの4倍を超える。
C
脆弱性の調査や防御の仕事をしている人:試す価値がある
他社モデルが断る作業を引き受けるなら、価格が高くても業務が成立する。ただし、断られるかどうかは自分の課題で確かめるしかない。数十件の実データで、現在使っているモデルと並べて結果を見たい。
D
データを国外に出せない組織:重みの公開待ち
欧州内のデータセンターで学習され、欧州内での提供も用意されている点と、重みを自社環境で動かせる可能性は、法令やデータの置き場所に制約がある組織にとって別の軸になる。判断はライセンスの条件が出てからだ。
Section 07
編集部の見立て
Editor's Opinion
今回のLarge 4は、点数だけを見ると「Lunaと同じで8倍高いモデル」にしか見えません。それでも注目に値すると考えるのは、売り方が価格競争から降りているからです。Mistralは安さで勝負せず、「断らない」「自社で持てる」「欧州で完結する」という、点数に表れない軸で選ばれようとしています。
これは選ぶ側にとって、比較の物差しが1本増えたことを意味します。これまでは知能と価格の2軸で考えれば足りました。これからは、その仕事を引き受けてくれるか、データがどこで処理されるか、自前で持てるかという軸が加わります。同じ点数のモデルを並べて安いほうを選ぶ判断が、通用しない仕事が出てきました。
ただし、今の時点で結論を出すのは早いと思います。割引の終わり方、文脈長の確定値、ライセンスの条件。決め手になる情報は、どれも10月末までにこれから出てくるものです。サイバー分野の優位も、自社の公表値を第三者が追試するまでは仮説の域を出ません。
Section 08
まとめ
2026年10月6日、Mistral AIが新しい旗艦モデルMistral Large 4を先行公開しました。総パラメータ数は約1兆、有効は490億で、標準価格は入力1.36ドル・出力4.18ドルです。
独立測定機関Artificial Analysisの知能指数は38点で、GPT-6 Lunaと並びます。出力単価はLunaの約8.4倍、書く量も同格モデルの中央値の約2.5倍で、指数の課題あたりの費用は標準価格で1.13ドルでした。
強みとして示されたのは、サイバーセキュリティ作業を断らないことと、10月末に予定される重みの公開です。ただし拒否の挙動は自社の説明にとどまり、ライセンスの条件も、文脈長の確定値も、割引の終了日も、まだ出ていません。
次に確かめられるのは10月末だ。重みが実際に公開されるか、ライセンスが商用利用を認める形か、そして半額の特別価格が終わった後の標準価格で、Lunaとの差がどこまで残るか。この3点が、同じ38点のモデルを選ぶ理由になるかを決める。