Nvidia出資のスタートアップ、Reflection AIが米国時間10月5日、初のオープンウェイトモデル「Beam」を発表した。総パラメータ数は5,010億、1トークンごとに動くのは230億。コーディングとエージェント作業(AIが自分で手順を組んで道具を使う仕事)向けに作られたという。
オープンウェイトとは、モデルの中身(重み)が公開され、誰でもダウンロードして自前の環境で動かせる形のことだ。いま話題の中心にいるオープンモデルは、Kimi K3やGLM 5.2など中国発のものが多い。Beamは、そこに米国から割り込むための一手として注目されている。
ただし、先に押さえておくべき点が3つある。重みの公開は「10月中」で日付は未定、価格は未公表、成績表はすべてReflection自身の発表だ。いまこの瞬間に使えるのは、待機登録をした一部の人だけである。
⚠ 情報の鮮度について
一次情報はReflection AIの公式ブログと、同日のTechCrunchの報道です(いずれも米国時間2026年10月5日)。本記事の公開時点で、発表から半日足らずです。成績表の数字はすべて発表元の自己申告で、第三者による再現測定はまだ見つかっていません。重みが公開されていないため、外部の人が自分で確かめることもできない状態です。
Section 01
Reflection AI Beamとは──何が発表されたのか
Beamは、Reflection AIが初めて世に出す大規模モデルだ。同社はブルックリンに拠点を置き、Google DeepMind出身の2人が2024年に創業した。公式ブログによれば、仕組みは「疎なMixture-of-Experts(MoE)」と呼ばれるものである。
MoEとは、モデルの中に多数の専門家(小さな部分)を用意しておき、1トークン(AIが文章を処理する最小単位)ごとに一部の専門家だけを呼び出す設計のことをいう。全体は巨大でも、実際に動かす部分は小さく済む。Beamの場合、全体の5,010億に対して、動かすのは230億だ。全体の約4.6%、倍率にして約22倍の差になる。
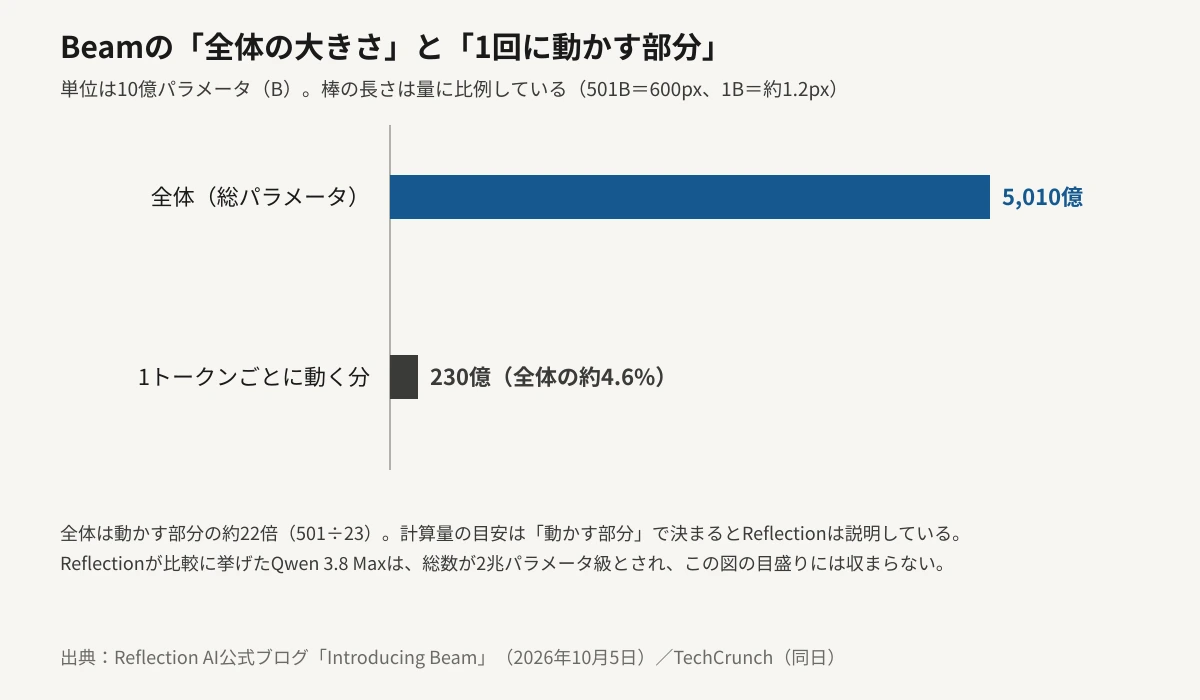
501B
総パラメータ数(5,010億)
23B
1トークンごとに動く分(230億)
23.8兆
事前学習に使ったトークン数
文章だけを扱うテキスト専用モデルで、画像や音声は入力として直接受け付けない。扱える文脈の長さは、TechCrunchの記事によれば100万トークンとされている。仕上げの強化学習には、NVIDIAのGB300を1万500基使い、約4週間で1億回を超える試行(ロールアウト)を回したと公式ブログは説明する。
一言でまとめると──「米国発の大型オープンモデルが、中国勢の背中が見える位置まで来た。ただし重みも価格もまだ出ておらず、成績表は自社発表だけ」。いま読者が乗り換える理由は、まだありません。
Section 02
いま触れるのか──重みは「今月中」、価格は未公表
発表時点で使えるのは、待機登録(ウェイトリスト)を済ませた一部の利用者向けの早期アクセスだけだ。重みの公開については、公式ブログが「Apache 2.0ライセンスで、今月後半に公開する予定」と述べている。Apache 2.0は商用利用や改変を広く認める代表的なライセンスで、条件が緩いことで知られる。ただし公開日そのものは示されておらず、現在は最終的なレッドチーム(わざと攻撃して弱点を探す検証)と評価を進めている段階だという。
価格は、公式の発表にも開発者向けページにも書かれていない。API(外部のプログラムからモデルを呼ぶ仕組み)で売るというより、企業や国が自前の環境で動かす使い方に重心を置いているようだ。TechCrunchも、狙う客層は企業と国家だと伝えている。
ⓘ 早期アクセスの文脈長について(※観測)
発表では100万トークンの文脈をうたっていますが、開発者向けの解説記事の1本は、早期アクセスで文書化されている上限は入力と出力を合わせて26万2,144トークンだと伝えています。学習時は25万6,000トークンまでで、運用時に100万まで広げる設計と読めます。一次情報の1本だけでは確定できないため、実際に使える長さは重みの公開後に確かめる必要があります。
10月5日(米国時間)
Beamを発表 成績表・仕様を公開。待機登録の受け付けを開始。
10月後半(予定)
重み・技術レポートを公開 Apache 2.0で配布する予定。日付は未定。レッドチームと評価の完了が前提。
未定
価格の公表 現時点でトークン単価は示されていない。
Section 03
BeamとKimi K3・GLM 5.2の違い──自社発表の成績表
Reflectionは公式ブログに、Beamと中国発の主要オープンモデルを並べた比較表を載せている。見出しの要約は「GLM 5.2に並び、Qwen 3.8 Maxに迫る。ただしKimi K3は生の能力でまだ上」という自己評価だ。TechCrunchはこれを受けて、西側の主要なオープンモデルを上回る、と伝えている。
表のうち、複数の媒体が同じ数字を再掲していて、4モデルがそろっている行を抜き出す。
| 指標(高いほど良い) | Beam | GLM 5.2 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|---|---|
| Terminal Bench 2.1(端末操作の自律作業) | 80.1 | 81.0 | 86.6 | 88.3 |
| HLE・ツール無し(難問の知識) | 36.2 | 40.5 | 43.6 | 46.9 |
| GPQA Diamond(大学院レベルの科学) | 90.5 | 91.2 | 92.6 | 93.5 |
| SWE-Bench Pro v1(実在コードの修正) | 65.5 | 62.1 | 67.7 | 掲載なし |
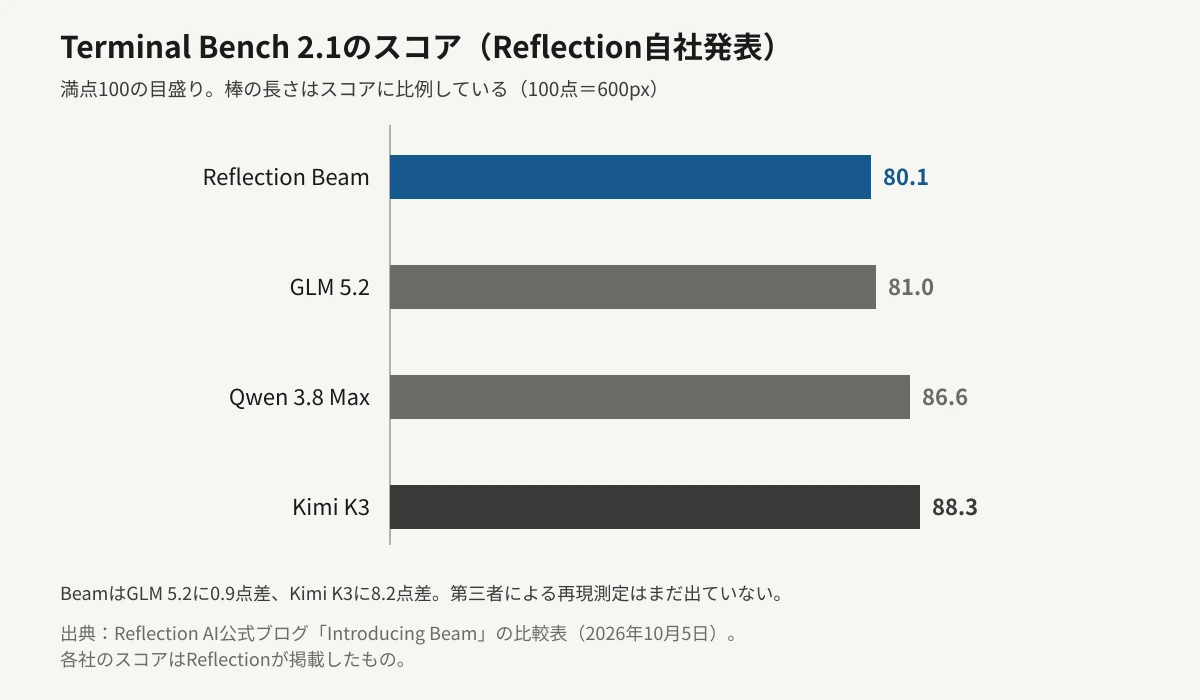
数字が語っているのは、かなり控えめな勝ち方だ。Terminal Benchでは、Beamは81.0のGLM 5.2に0.9点届かず、Kimi K3には8.2点離されている。HLEやGPQAでも、4モデルの中では最も低い。実在コードの修正を測るSWE-Bench Pro v1だけは、Beamの65.5がGLM 5.2の62.1を上回る。
つまり、全体としては「GLM 5.2と同じ集団の端にいる」という位置づけだ。首位争いではない。この表は、載せる指標も比べる相手も発表元が選んだものである点を、割り引いて読む必要がある。
Section 04
「計算量は3〜4分の1」は何を測った数字か
Beamの売りは、成績そのものより効率のほうにある。公式ブログは、高度な推論系の試験でGLM 5.2と同等の得点を出しながら、推論に使う計算量は3〜4分の1で済むと述べている。2兆パラメータ級のQwen 3.8 Maxとの比較では、差はさらに開くという。
この数字の測り方も、ブログに書かれている。計算量は「2 ×(1トークンごとに動く分のパラメータ数)×(1回の挑戦で生成した平均トークン数)」で近似したものだ。動かす部分が小さければ、1トークンあたりの計算は減る。Beamの230億は、その意味で有利に働く。
推論計算量(FLOPs)は、動かすパラメータ数の2倍に、1回の挑戦で生成した平均トークン数を掛けて近似する。
— Reflection AI公式ブログの説明を要約(2026年10月5日)
ただし、この式には含まれないものがある。開発者向けの報道によれば、計算から除かれているのは、最初に入力を読み込む処理(プリフィル)、長い文脈での注意計算、そして実際に動かすときのサーバー側の負担だ。同じ報道は、これを「モデル側の計算量の比較であり、利用者が払う金額の見積もりではない」と整理している。
💡 読み方のコツ
「計算量が少ない」と「請求額が安い」は別の話です。Beamの価格が出ていない以上、3〜4分の1がそのまま料金に反映されるかどうかは、いまは言えません。重みが公開されて、ホスティング事業者が値付けを始めてから比べるのが確実です。
Section 05
あなたのAI選びは、いま変わるのか
結論から言えば、今日の時点で乗り換える理由はない。立場ごとに分けて整理する。
B
CursorやGitHub Copilotで選ぶ人:まだ選べない
発表の時点で、両ツールがBeamを選択肢に加えたという発表は確認できていない。重みが公開されて、各ツールが採用してはじめて、モデル一覧に並ぶかどうかが決まる。
C
自社でモデルを動かす開発者・企業:評価の候補に入れる
中国発のモデルを避けたい事情がある組織にとって、Apache 2.0で使える米国発の選択肢が増える意味は大きい。ただし公開前の今は、待機登録して小さく試す段階だ。
オープンモデルへの乗り換えは、すでに現実の経営問題になっている。法務AIのHarveyが、フロンティア各社のAPIからKimi K3へ土台を替えて粗利率が大きく動いたという報道は、以前の記事で整理した。Kimi K3そのものの大きさはこちらの記事にある。Beamは、その選択肢の隣に並ぶ候補になる。
⚠ 重みが出る前に決めないほうがよいこと
公開前のモデルを前提に、社内のモデル選定や契約を動かすのは避けたほうが無難です。成績表が自社発表のままであること、価格が未定であること、文脈長の実効値が確認できていないことの3点が、重みの公開と第三者の測定で埋まるまで残ります。
Section 06
編集部の見立て
Editor's Opinion
今回の発表で注目しているのは、成績の絶対値より、Reflectionが「勝った」と言っていない点です。Kimi K3が上だと自分から認め、勝負どころを推論時の効率に置いています。強がらずに、測れる軸を選んで主張している姿勢は、公開前の発表としては誠実だと感じます。
一方で、その効率の数字は、料金とは別物でした。除かれている部分が、実際の運用では請求額を左右する場面が多いからです。長い文脈を何度も読み込ませる使い方ほど、プリフィルの比重は大きくなります。コーディングの現場は、まさにその使い方です。3〜4分の1という数字は、価格が出た時点で別の顔を見せる可能性があります。
Cursorのようなコーディングツールの利用者にとっての意味は、もう少し先に現れるでしょう。選択肢に入るかどうかは、重みの公開後に各ツールがどう動くかで決まります。いまは、10月の公開日と、第三者が出す最初の測定結果を待つ局面です。
Section 07
まとめ
Reflection AIが米国時間2026年10月5日、初のオープンウェイトモデル「Beam」を発表しました。総パラメータ5,010億、1トークンごとに動くのは230億のMoE型で、コーディングとエージェント作業向けです。
重みはApache 2.0で10月後半に公開予定ですが、日付は未定で、価格は未公表です。現時点で使えるのは待機登録した一部の利用者だけです。
成績表は自社発表で、Terminal Bench 2.1ではGLM 5.2(81.0)にわずかに届かず(80.1)、Kimi K3(88.3)とは8.2点の差があります。「計算量は3〜4分の1」という主張も、プリフィルなどを除いたモデル側の比較で、料金の話ではありません。
ChatGPT・Claude・Gemini、そしてCursorやGitHub Copilotの利用者にとって、今日の選び方を変える材料はまだありません。
次に確かめられるのは、10月後半とされる重みの公開日です。公開されれば、第三者の測定、ホスティング各社の単価、そしてCursorやGitHub Copilotが選択肢に加えるかどうかが、順に見えてきます。