AIエンジニア「Devin」を作るCognitionが11月4日、新しいコーディング特化モデル「SWE-2 Flash」を発表した。9月に出した「SWE-2」の軽量版にあたり、同社の説明では価格はSWE-2の5分の1、速さは約3倍。DevinのデスクトップアプリとCLIで使え、11月30日までは無料になっている。
ただし、これはAPIで呼び出せるモデルではない。モデル名も、トークン単価も、重みも公開されていない。Cursor や GitHub Copilot を使っている開発者がすぐ切り替えられる話ではなく、「コーディングAIの安く速い層で何が起きているか」を読むための材料として見るのが実態に近い。9月の「SWE-2」がどんなモデルだったかは、前回の記事で整理している。
⚠ 情報の鮮度について
一次情報はCognition公式ブログ「SWE-2 Flash」(2026年11月4日付)と同社の公式X投稿です。公開時刻は明記されておらず、本記事の公開時点で2日前後が経過しています。このため速報ではなく、選ぶ側にとっての意味を整理する解説として書いています。本文の成績・速度・価格比はすべてCognitionの自己申告で、第三者による再現は確認できていません。
Section 01
SWE-2 Flashとは──Devinに載った「軽いほう」のモデル
SWE-2 Flashは、Devinの中で動くコーディング専用のAIモデルだ。バグ修正や機能追加、コードレビュー、ドキュメント更新といった定型寄りの作業を、より速く安く回すために作られた。名前の「Flash」は、同じシリーズの上位モデルSWE-2に対する「軽量・高速版」を意味している。
公表されている条件を、SWE-2と並べると次のようになる。
| 項目 | SWE-2 Flash | SWE-2(9月発表) |
|---|---|---|
| 価格 | SWE-2の5分の1(Cognition説明) | 基準 |
| 生成速度(Cognition試算) | 毎秒200トークン | 毎秒60トークン |
| 使える場所 | Devin DesktopとDevin CLI | Devin Desktop、Devin CLIほか |
| 無料期間 | 11月30日まで | 記載なし |
| API・モデルID・重み | いずれも公開なし | Devin内での提供 |
「毎秒200トークン」と「毎秒60トークン」は、およそ3.3倍の開きになる。Cognitionが「約3倍速い」と言っているのはこの比だ。ただし速度は、実際のサーバーを計測した値ではない。Terminal-Bench 4.0の1回分の作業記録を、同じ長さに揃えたうえで、それぞれの速度で再生した場合の試算とされている。トークンとは、AIが文章やコードを処理する単位のことで、日本語なら1文字がおよそ1〜2トークンに相当する。
もう一点、「5分の1」はSWE-2に対する比率であって、1トークンあたりの単価ではない。Devinは利用量をまとめた課金体系で、トークン単価の料金表は出ていない。無料期間が終わったあとの実際の費用は、11月6日時点では誰にも計算できない。
一言でまとめると──「Devinの中だけで使える、速くて安い軽量モデルが出て、11月30日までは無料」。API単価が公開されていないので、外から値段を比べる段階にはまだ来ていません。
Section 02
安くなった代わりに、どこが削られたのか
軽量版は、上位モデルより何かを手放しているのが普通だ。Cognitionが公表した成績を、上位のSWE-2と並べると、手放した部分が見える。
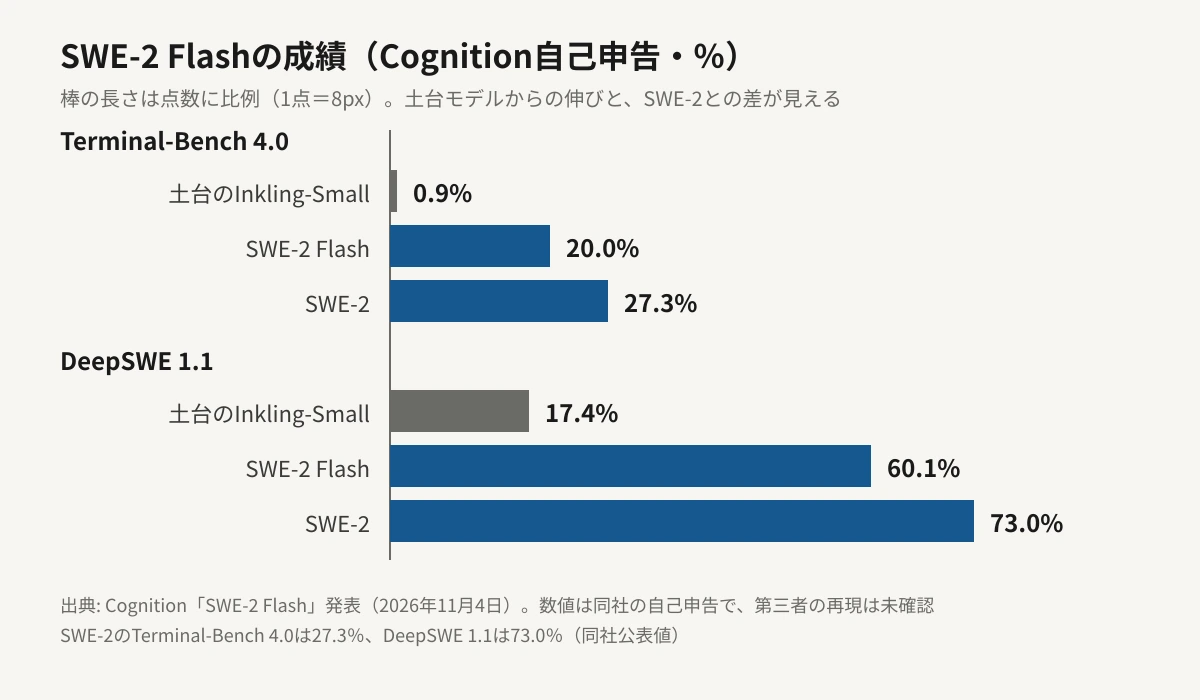
長い作業を測るTerminal-Bench 4.0では、Flashが20.0%、SWE-2が27.3%。差は7.3ポイントある。一方、より短い課題の完遂率を測るDeepSWE 1.1では、Flashが60.1%、SWE-2が73.0%で、差は12.9ポイントに広がる。
逆に、差が小さい指標もある。Terminal-Bench 2.1ではFlashが89.2、SWE-2が92.8と、3.6ポイントしか離れていない。つまり、手応えのある作業をやらせるほど上位モデルとの差が出て、点数が高く出やすい標準的な課題では差が縮む、という並びになっている。
01
差が小さい:標準的な作業
Terminal-Bench 2.1の89.2対92.8のように、区切りのよい作業なら上位モデルに近い点が出る。定型の修正や下書きの量産はこの層にあたる。
02
差が開く:難しい課題
DeepSWE 1.1の60.1対73.0のように、課題が重くなるほどSWE-2との差が広がる。設計をまたぐ修正は上位モデルのほうが安全だ。
03
差が最も読みにくい:長時間の自律作業
Terminal-Bench 4.0は20.0対27.3。どちらも上位の水準ではないので、長い調査を丸ごと任せる使い方は、人が結果を見直せる範囲にとどめたい。
Section 03
土台はThinking MachinesのInkling-Small
SWE-2 Flashの土台は、元OpenAIのミラ・ムラティ氏が率いる研究所Thinking Machines Labのモデル「Inkling-Small」だ。全体で2,760億パラメータ、そのうち実際に動くのは120億という「専門家混合(MoE)」型で、入力ごとに一部の部品だけを使う作りになっている。パラメータとは、モデルの中の調整値の数で、多いほど大きなモデルを指す。この研究所の背景は資金調達を報じた記事で触れた。
9月のSWE-2は、中国発のオープンウェイトモデルKimi K3を土台にしていた。今回は、米国の研究所のモデルに変わっている。Cognitionは土台に対し、事前学習と強化学習のあいだに「ミッドトレーニング」と呼ぶ追加の学習段階を入れたという。
土台のInkling-SmallはTerminal-Bench 4.0で0.9%、DeepSWE 1.1で17.4%だった。Cognitionの調整を経たSWE-2 Flashは、それぞれ20.0%と60.1%まで伸びた。
— Cognition公式ブログの数値より(2026年11月4日)
0.9%から20.0%という伸びは、土台そのものよりも、その後の調整の効果が大きいことを示す。Cognitionは「米国発のオープンウェイトモデルのうち、3倍大きいものも含めて、主要な評価で上回る」とも述べている。ただし、これは同社が選んだ評価での自己比較で、第三者の検証は出ていない。
Section 04
重みが出ない理由は、サイバー能力の伸び
モデルの重みとは、学習で決まった内部の数値の全体で、これを配れば他者が自分の環境でモデルを動かせる。Cognitionは今回、この重みを公開していない。理由として挙げたのは、サイバー攻撃に使える能力まで伸びてしまったことだ。
攻撃手法の理解度を測るExploitBenchで、土台のInkling-Smallは11.3%だったが、SWE-2 Flashは34.8%になった。同社は「同じ能力が悪意ある攻撃者の助けにもなりうる」と説明し、信頼できる業界パートナーや研究機関にだけ安全に共有する仕組みを作っている。詳細は「数週間のうちに」示すとしている。
ⓘ 「オープンウェイト」という看板は付いていない
Cognitionの発表では、他の米国製オープンウェイトモデルと比べた成績が強調されていますが、SWE-2 Flash自体の重みは誰でも入手できる状態にはありません。共有の申請方法、条件、ライセンス、時期はいずれも11月6日時点で示されていません。自社のサーバーで動かすことを前提にした計画は、立てられない状況です。
ここ数か月、強いモデルの重みを公開するか否かの判断は、サイバー能力を理由に分かれる流れが続いている。Kimi K3.1 Proではサイバー能力を削った重みを後から公開する形が取られた。Cognitionは逆に、能力を残したまま公開を絞る道を選んだことになる。
Section 05
Devin・Cursor・Copilotの利用者はどうするか
A
Devinを使っている人:11月30日までに試す
無料期間のあいだに、いまSWE-2でやらせている作業の一部をFlashへ回し、結果を並べて見る。区切りのよい修正やドキュメント更新が向く。無料の間は費用が見えないので、料金が決まる前に「どの作業ならFlashで足りるか」を決めておける。
B
CursorやGitHub Copilotを使っている人:切り替え先はまだない
Flashは両ツールのモデル一覧に加わっていない。APIがないので、他のツールから呼ぶこともできない。いまの使い方を変える材料は、この発表には含まれていない。
C
自社で動かしたい人:待つしかない
重みの共有プログラムは条件が未発表で、一般の開発者が対象になるかも分からない。すでに重みが公開されているモデルを検討するほうが現実的だ。
⚠ 試すときの確かめ方
Flashの成績はCognitionが自社で測った値です。判断の材料にするなら、自分のリポジトリで同じ課題を20〜30件ほどSWE-2とFlashの両方に流し、直したコードがテストを通るかを数えてください。速度も、サーバーの混み具合で試算とは変わります。
Section 06
編集部の見立て
Editor's Opinion
今回の発表で気になったのは、性能そのものより、提供の形です。価格は「SWE-2の5分の1」という自社比、速度は再生した記録からの試算、成績は自社の評価。そして出口はDevinの中だけです。外から検証するための手がかりが、ほとんど用意されていません。
これは悪意ではなく、重みを出せない事情と、料金をまだ決めていない段階が重なった結果だと考えます。ただ、読者の立場では、数字が良く見えるほど「どう測ったか」を確かめる必要があります。無料の期間は、その確認をする時間として使うものです。
一方で、9月のSWE-2から2か月足らずで、土台を替えた軽量版が出てきた速さは、注目に値します。コーディングAIの層は、フロンティアの頂点だけでなく、その一段下の「速くて安い」帯でも動きが激しくなっています。ツール選びでモデル名を見るときは、その帯がどこまで上位に迫るかを、数か月単位で見直す場面が増えそうです。
Section 07
まとめ
CognitionのSWE-2 Flashは、2026年11月4日に発表されたDevin向けのコーディングモデルです。Cognitionの説明では、価格はSWE-2の5分の1、速度は毎秒200トークン対60トークンで約3倍。Devin DesktopとDevin CLIで使え、11月30日までは無料です。
成績はTerminal-Bench 4.0で20.0%(SWE-2は27.3%)、DeepSWE 1.1で60.1%(同73.0%)。上位モデルとの差は、課題が重くなるほど開きます。土台はThinking MachinesのInkling-Small(2,760億パラメータ、うち120億が稼働)で、ExploitBenchが11.3%から34.8%に伸びたことを理由に、重みは公開されていません。
API、モデルID、トークン単価はなく、すべての数値はCognitionの自己申告です。CursorやGitHub Copilotからは使えません。
無料期間が終わる11月30日までに、Devinの料金表にFlashがどう載るかと、重みの共有プログラムの条件が示されるかが、次の確認点になる。