元OpenAI CTOのミラ・ムラティ氏が率いるThinking Machines Labが11月20日、小型モデル「Inkling 2 Mini」の重みをHugging Faceで公開した。総パラメータは264億(26.4B)で、メモリ32GB以上のMacならOllamaで動かせると同社は案内している。11月5日に発表した5,940億パラメータのInkling 2 Smallの、手元の機械向けの弟分にあたる。
独立した計測機関のArtificial Analysisは、この小型機を知能指数20点と測った。同じ20点のQwen3.8 27Bと比べると、試験1問あたりの費用は約6分の1、所要時間は38.2分に対して9.0分だった。一方で、OpenAIの軽量モデルGPT-6 Luna(max)は同じ物差しで28点を取り、1問あたりの費用はさらに安い。
ノートPCで動くこと自体は、もう珍しくない。この記事では、Inkling 2 Miniが何をどれだけ縮めたのかと、ChatGPTやClaudeをクラウドで使っている人にとって、手元で動かす選択肢がどこまで現実的になったのかを整理する。
⚠ 情報の鮮度について
一次情報はThinking Machines Lab公式の発表「Introducing Inkling 2 Mini」とHugging Faceのモデルカード(いずれも2026年11月20日付)、およびArtificial Analysisの同日付の計測記事です。発表から1日たっていません。ベンチマークのうち、Artificial Analysisの知能指数と1問あたりの費用・時間は同社の計測で、それ以外のDeepSWEなどの成績はThinking Machines Labの自己申告です。
Section 01
Inkling 2 Miniとは──中段の層を3回まわす小型モデル
Inkling 2 Miniは、専門家混合(MoE)と呼ばれる作りのモデルだ。全体では264億の重みを持つが、1トークンを処理するたびに実際に使うのはそのうち34億(3.4B)にとどまる。辞書を丸ごと持ち歩きながら、引くのは必要なページだけ、という作りである。
変わっているのは、その先だ。同社はこれを「ループ型トランスフォーマー」と呼ぶ。24層を6層ずつ4つの塊に分け、最初と最後の塊は1回だけ、真ん中の2つの塊(12層)は1トークンごとに3回くり返して通す。同じ重みを3度使うので、ファイルの大きさは増やさずに、計算の深さだけを足せる。くり返し分を数に入れると、1トークンあたりに働く重みは54億(5.4B)相当になる。
26.4B
総パラメータ(264億)
3.4B
1トークンで使う重み(くり返し込みで5.4B相当)
3回
中段12層を通す回数
兄貴分のInkling 2 Smallは、総パラメータ5,940億・1トークンで使う重み170億という規模で、11月5日に同社のサービスTinker上で公開され、重みも11月12日にHugging Faceで配布が始まった。強みはどちらも、長い手順を自分で進めるエージェント型の仕事にあると同社は説明している。
💡 「くり返し」で考えが見えにくくならないか
同社は発表の中で、層をくり返すほど、モデルが考えを文章に書き出さずにこなせる仕事が長くなることを報告しています。研究用に用意したくり返し回数を変えられる版では、考えを書き出さずに解ける仕事の長さ(人間の作業時間に換算)が、1回通しの16秒から3回通しの37秒に伸びました。そのうえで同社は、この規模では推論の過程を外から監視しにくくなる傾向は見られなかったとしています。くり返しを増やした将来のモデルでも同じことが言えるかは、まだわかりません。
Section 02
「32GBのMacで動く」の中身
重みの大部分は4ビット相当の形式(NVFP4)で、最後の4層だけを8ビット相当(MXFP8)で持つ。これでファイル全体は約20GBに収まる。最初からこの精度で学習しているので、後から圧縮したときのような劣化は無いと同社は説明する。
動かせる機械として同社が挙げているのは、メモリ32GB以上のMac(MacBook・Mac mini)でのOllama、NVIDIAの小型AIコンピュータDGX Spark、そしてVRAM 32GB以上のGPUだ。言い換えると、メモリ16GBのノートPCや、VRAM 24GBのGPUは推奨の範囲から外れる。軽量化した派生版はUnslothやllama.cppの形式でも配られている。
| 項目 | Inkling 2 Mini |
|---|---|
| ライセンス | Apache 2.0(商用利用・改変が可能) |
| 文脈の長さ | 最大100万トークン |
| 入力 | 文章と画像(出力は文章のみ) |
| ファイルの大きさ | 約20GB |
| 推奨する機械 | メモリ32GB以上のApple silicon機/DGX Spark/VRAM 32GB以上のGPU |
| クラウドで使う場合 | 同社のTinkerで推論・追加学習・チャット画面 |
ライセンスと文脈の長さは、Hugging Faceのモデルカードに記載がある。Apache 2.0は、表示さえ守れば社内システムに組み込むのも、追加学習して自社製品にするのも自由な、制約の少ない部類のライセンスだ。10月に出たMeta Muse Spark Openのように、売上や表示の条件が付くライセンスとは扱いやすさが違う。
Section 03
同じ点数を、5分の1の動く部品で取った
Artificial Analysisの知能指数は、推論・知識・コーディングなど複数の試験をまとめた総合点である。Inkling 2 Miniの点数は20点で、8月に紹介したQwen3.8-27B(xhigh設定)、Nanbeige4.3-33Bと同点だった。違いは、そこに至るまでの体の大きさだ。Artificial Analysisによれば、1トークンで働く重みはQwen3.8 27Bの約5分の1、Nanbeige4.3-33Bの約6分の1で済んでいる。
費用と時間にも差が出た。Artificial Analysisが知能指数の試験1問を解かせたときの平均は次のとおりだ。
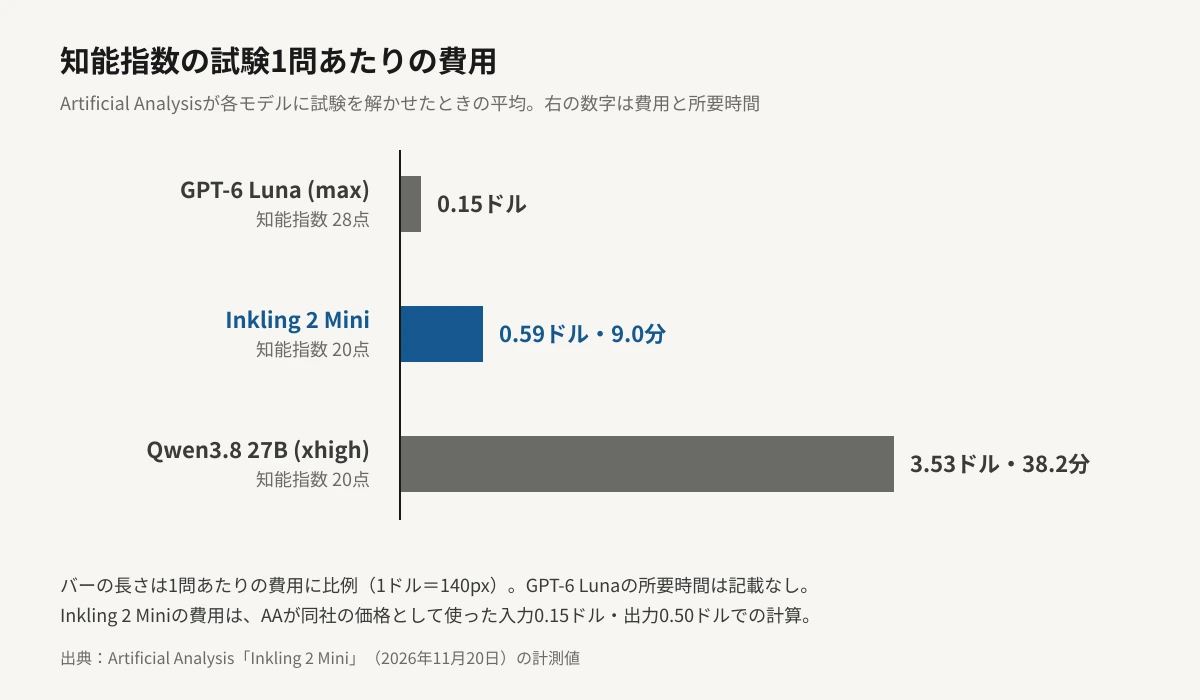
Inkling 2 Miniは1問あたり0.59ドル・9.0分、Qwen3.8 27Bは3.53ドル・38.2分。費用は約6分の1になった。おもしろいのは、Inkling 2 Miniのほうが答えを出すまでに書く文章は長い点だ。1問あたりの出力はInkling 2 Miniが約15万2,000トークン、Qwen3.8 27Bが約11万トークンで、約38%多い。それでも1トークンを作る計算が軽いので、計算量の合計ではQwen3.8 27Bの約2.8分の1に収まっている。
ⓘ この費用はどの単価で計算されたか
Artificial Analysisは、Thinking Machines Lab自身の価格として入力0.15ドル・出力0.50ドル・キャッシュ読み出し0.015ドル(いずれも100万トークンあたり)を使って費用を計算しています。この値は、Tinkerの料金表(10月19日時点の版)の学習・サンプリング用の単価(入力0.15ドル・キャッシュ0.015ドル・出力0.50ドル)と一致します。ただし、学習をせずに呼び出すだけの従量のサーバーレス推論(ベータ)の対象はInkling 2 Small・Inkling・Inkling-Smallの3つで、Inkling 2 Miniはまだ入っていません。手元のMacで動かすなら、この費用は電気代に置き換わります。
同社の自己申告の成績も並べておく。プログラムの修正を自力で進める試験DeepSWE v1.1では48.2%で、Qwen3.8-27Bの42.2%を上回り、同社は総パラメータ1,000億未満の公開モデルで首位だとしている。逆に、何往復も続く会話や、条件をたくさん付けた指示は苦手だと同社自身が認めている。会話の続け方を測るMultiChallengeは50.0%、多数の制約を守れるかを測るComplexConstraints v1.1は33.4%だ。同社は文中で「どちらもQwen3.8-27Bに及ばない」と書いているが、同じ発表の表ではComplexConstraints v1.1のQwen3.8-27Bは30.1%で、Inkling 2 Miniのほうが上になっている(この試験の首位はMuse Glimmerの35.6%)。発表の文と表が食い違っている点は、割り引いて読んでおきたい。
Section 04
それでもGPT-6 Lunaには届かない
ここで、クラウドの軽量モデルと並べてみる。Artificial Analysisは同じ記事の中で、OpenAIのGPT-6 Luna(max)が知能指数28点、1問あたり0.15ドルだと書き添えている。点数は8点上で、費用はInkling 2 Miniの0.59ドルより安い。
一言でまとめると──「同じ大きさの公開モデルの中では、少ない計算で同じ点を取る効率の良い1本。ただ、賢さと費用の両方で、クラウドの軽量モデルを追い越したわけではない」です。
つまり、「安く賢い答えがほしい」だけなら、いまはまだChatGPTの運営元のAPIを呼ぶほうが有利だ。Inkling 2 Miniを選ぶ理由は、値段ではなく別のところに置く必要がある。
01
データを外に出さない
手元の機械で完結するので、文章やコードがネットワークの外に出ない。社外のサービスに渡せない資料を扱う職場では、性能差より先にこの条件が決め手になる。
02
回線が無くても動く
同社は、ネットにつながないMacBook Proの上で、簡単なフライトシミュレーターを数分で作らせた例を示している。移動中や回線の細い現場でも使える。
03
自分用に作り変えられる
Apache 2.0の重みなので、社内の書式や用語に合わせた追加学習ができ、その成果物を自社の製品に組み込める。クラウドのモデルでは、ここまでは手が届かない。
Section 05
手元で動かす意味がある人、ない人
判断の入口は、手元の機械のメモリである。32GBに届かないなら、この記事の話はひとまず関係がない。届いているなら、次に「その仕事のデータは社外へ出してよいか」を考える。
出してよいデータで、会話しながら考えをまとめる使い方が中心なら、ChatGPTやClaudeの月額プランを替える理由は見当たらない。Inkling 2 Miniが苦手だと自己申告しているのは、まさにその何往復も続く会話だからだ。
出せないデータで、コードの修正や調べものを手順どおりに進めさせたい場合は、試す価値が出てくる。GitHub CopilotやCursorのようなクラウド経由のコーディング支援を、社内規定の都合で使えずにいる開発者がいちばんの読者になる。10月に紹介したRecursive Flintと同じ棚に並ぶ選択肢で、Inkling 2 Miniは、知能指数と費用を第三者のArtificial Analysisが測っている点が判断材料になる。
⚠ 試す前に確かめること
20GBのファイルを読み込むと、32GBのMacではメモリの大半がモデルに取られます。ブラウザや開発ツールを開いたまま動かすと、残りのメモリで足りるかどうかは文脈の長さ次第です。100万トークンの文脈は仕様上の上限で、手元の機械でその長さを流せるとは限りません。まずは短い作業で速度とメモリの使用量を確かめてください。
Section 06
編集部の見立て
Editor's Opinion
Inkling 2 Miniで目を引くのは、点数そのものより、同じ20点に届くまでの道のりの短さです。1トークンで動かす重みを絞った専門家混合の作りのおかげで、Artificial Analysisの推計では計算量の合計がQwen3.8 27Bの約2.8分の1に収まりました。同じ層を3回通す工夫は、ファイルを大きくせずに計算の深さを足すためのものです。手元の機械で動かすモデルにとって、これは性能表の1行以上の意味を持ちます。電池の持ちも、ファンの音も、待ち時間も、計算量で決まるからです。
一方で、GPT-6 Lunaが28点を0.15ドルで出している以上、「手元で動くから安い」という売り方はもう通りません。クラウドの軽量モデルは、点数でも値段でも先を走っています。手元で動かすモデルの価値は、データを外に出さないこと、回線が要らないこと、作り変えられることの3つに絞られてきたと考えます。
9月に評価額400億ドルでの調達交渉が報じられた同社にとって、小さな公開モデルは売上の柱ではないはずです。それでも7月の初代Inklingから数えて半年たたないうちに大小をそろえてきたのは、自社のTinkerで追加学習してもらう入口を広げたいからでしょう。Inkling 2 MiniがTinkerのサーバーレス推論の対象に加わる日が、その狙いがはっきりする日になると見ています。
Section 07
まとめ
Thinking Machines Labが2026年11月20日、Inkling 2 Miniの重みをApache 2.0で公開しました。総パラメータは264億、1トークンで使う重みは34億で、中段の12層を3回くり返して通す作りです。ファイルは約20GBで、同社はメモリ32GB以上のMacならOllamaで動かせると案内しています。
Artificial Analysisの知能指数は20点で、Qwen3.8 27Bと同点でした。試験1問あたりの費用は0.59ドルと3.53ドルで約6分の1、所要時間は9.0分と38.2分です。ただしGPT-6 Luna(max)は28点を1問0.15ドルで出しており、賢さと費用の両方で先を行っています。
何往復も続く会話と、条件の多い指示は苦手だと同社自身が認めています。データを外に出せない仕事で、コードの修正や調べものを手順どおりに進めさせる用途が、このモデルのいちばんの持ち場です。
次の焦点は、Tinkerのサーバーレス推論の一覧です。10月19日時点の版では、Inkling 2 Miniは学習・サンプリング用の単価(入力0.15ドル・出力0.50ドル)にだけ載っていて、呼び出すだけの従量推論の対象にはまだ入っていません。