中国の出前・生活サービス大手Meituan(美団)が2026年11月2日、AIモデル「LongCat-2.5」を公開した。総パラメータ数は1.6兆、画像と文章を一つのモデルで扱い、狙いは「何十手もかかる長いコーディングや操作を、途中で崩れずにやり切る」ことにある。API単価は出力100万トークンあたり1.20ドル(期間限定)。同じ時期のGPT-6.1 Terraの標準価格(出力5.00ドル)の約4分の1だ。
ただし、発表時点で出ているのは「APIとチャットで触れる」ところまでである。重みの公開は予定止まりで日付もライセンスも示されておらず、成績の比較は図の画像だけで、数字の表は公開されていない。安い、という事実と、使える、という確認のあいだに、まだ距離がある。
⚠ 情報の鮮度について
一次情報はMeituanの公式発表(2026年11月2日付)、LongCat APIの更新履歴(版2026-11-02)、同社の料金ページです。公開時点で、発表から24時間ほどです。成績の比較はMeituan自身の主張で、第三者の測定はまだ見つかっていません。料金は期間限定の割引価格で、終了日は示されていません。
Section 01
LongCat-2.5とは何か──出たものと、まだ出ていないもの
LongCatは、Meituanが開発しているAIモデルのシリーズだ。6月公開の前作LongCat-2.0は、同社の説明では「兆単位のパラメータを、国産の計算資源だけで学習から運用まで通した最初のモデル」とされる。2.5は9月25日にプレビュー版(試験公開)が先に出ており、11月2日の更新履歴で正式な項目として載った。
公式発表と報道から確認できる中身は、次のとおりだ。
1.6兆
総パラメータ数
約3%
1トークンごとに使う割合(約480億)
1.20ドル
出力100万トークンの単価(期間限定)
パラメータとは、モデルの内部にある調整値のことで、数が多いほど覚えられる量は増えるが、動かす費用もかさむ。LongCat-2.5は「混合専門家」(MoE)という作りで、巨大なモデルの中に専門家役の部分がたくさんあり、1トークンを処理するたびに一部だけを呼び出す。TechNodeの報道では、そのとき動くのは約480億で、総数の3%にあたる。1.6兆という大きな数字でも、1回の処理で動かす量はずっと小さい。
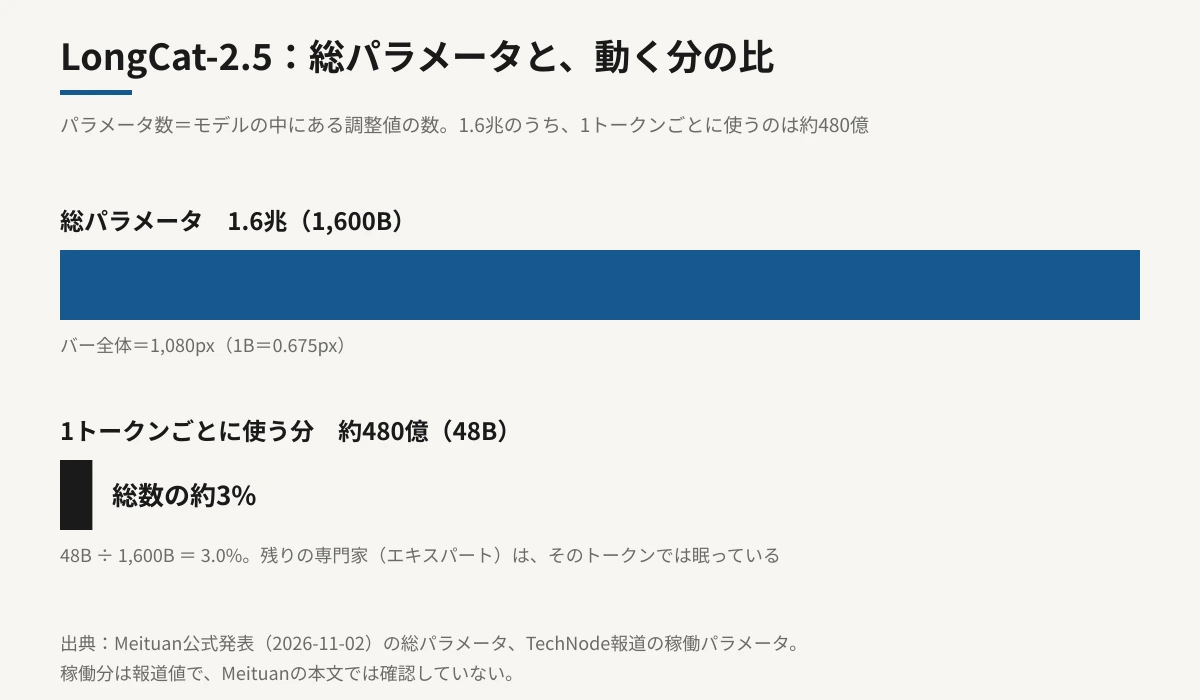
そのほか公表されている特徴は三つある。第一に、画像と文章を同じ枠組みのトークンに変えて処理する、ネイティブなマルチモーダル(最初から画像と文章を一緒に扱う方式)であること。第二に、強化学習(試行の成否から学ぶ訓練)で、実際のエージェントが失敗した場面を再現できる訓練課題に変えて使ったと説明していること。第三に、推論時に重みと中間値を4ビットで扱うW4A4という量子化(計算を軽くするための数値の粗さの調整)を採っていることだ。
一言でまとめると──「1.6兆パラメータの大型モデルが、APIで安く触れるようになった。ただし重みも数字の表もまだ出ていない」。手元で動かす話ではなく、まずはAPIの話です。
Section 02
LongCat-2.5の料金──期間限定の1.20ドルをどう読むか
LongCat APIの料金ページには、従量課金の単価が100万トークン単位で並ぶ。いずれも「期間限定の割引価格」と明記され、終了日は書かれていない。
| LongCat-2.5(100万トークンあたり) | 単価 | GPT-6.1 Terra(標準) |
|---|---|---|
| 入力(キャッシュなし) | 0.30ドル | 1.00ドル |
| 入力(キャッシュ利用) | 0.006ドル | 0.05ドル |
| 出力 | 1.20ドル | 5.00ドル |
キャッシュとは、同じ前置きの文章を繰り返し読ませるとき、2回目以降の入力を安くする仕組みだ。長い指示書や大きなコードを毎回読ませるエージェントの用途では、この欄の値が請求額を左右する。
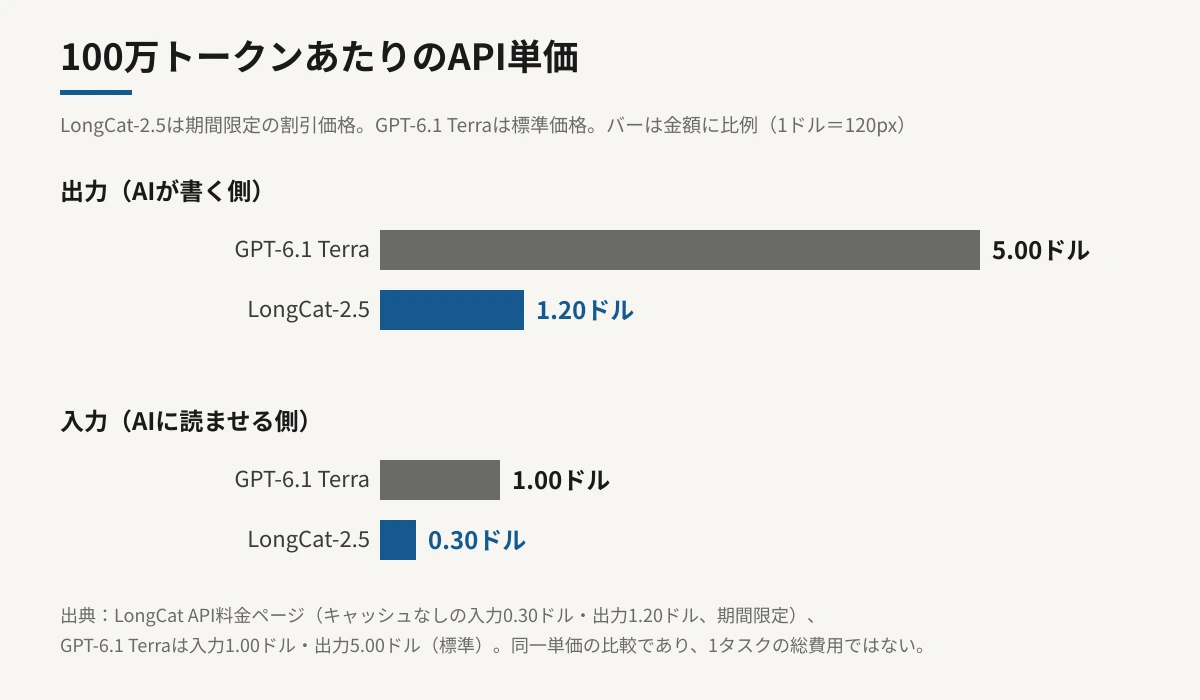
数字を並べると、出力は約4分の1、入力は約3分の1になる。ただし、これは単価どうしの比較で、1つの仕事を終えるまでの総費用ではない。モデルが違えば、同じ仕事に使うトークンの量も、やり直しの回数も違う。Kimi K3.1 Proの回でも触れたとおり、単価が3分の1に下がっても、1タスクの費用がほぼ横ばいという例がすでにある。
ⓘ 「期間限定」の読み方
料金ページには終了日の記載がなく、通常価格も示されていません。割引が終わったあとの単価が今より高くなる可能性は十分にあります(※観測。LongCat-2.5の通常価格は未公表)。
Section 03
Claude Opus 5に迫るという主張の中身
Meituanは公式発表で、いくつかの主要ベンチマークでClaude-Opus-4.8とClaude-Opus-5のあいだに入る成績で、一部の評価ではOpus 5を上回ると述べた。Claudeの最上位級に並んだ、という言い方だ。
ここで押さえるべきは、この比較の「出どころ」である。発表本文に具体的なスコアは書かれておらず、比較は図の画像として載っているだけだ。どのベンチマークを使ったか、条件はどうかは、テキストでは追えない。自社が選んだ競技で、自社が測った結果であり、第三者が同じ条件で再現した数字はまだ見つかっていない。
01
公表されているもの
規模(1.6兆)、APIの提供、期間限定の単価、Claude Codeなど既存の道具との互換性。更新履歴と料金ページで確認できる。
02
主張だけがあるもの
「Opus 4.8とOpus 5のあいだ」という位置づけ。数字の表がなく、図の画像だけで示されている。
03
まだ無いもの
重みの公開日とライセンス、第三者機関の測定、通常価格。Hugging Faceへの掲載は予定として報じられているのみ。
Section 04
Claude CodeやCodexの「中身」に使えるという意味
更新履歴によると、LongCat-2.5はClaude Code、Codex、Hermesなど既存のエージェント実行環境に差し込んで使える。プレビュー版の時点では、Claude Code、Hermes、OpenClaw、OpenCode、Kilo Codeが挙がっていた。
これは、AIコーディングの世界で進んでいる分業を映している。画面や操作の枠組み(ハーネス)と、中で考えるモデル(エンジン)が別々に選べるようになってきた。Claudeの道具を使いながら、中身だけを別のモデルに替える、という組み合わせが現実の選択肢になっている。ChatGPTのCodexも同じ扱いだ。
選ぶ側にとっての意味は二つある。一つは、道具を乗り換えずにモデルだけ試せるので、試すコストが小さいこと。もう一つは、その道具のメーカーが保証する範囲の外に出ることだ。互換とされていても、ツールの細かな機能(ファイル編集の形式、画像の渡し方など)が全部通るとは限らない。
Section 05
あなたはどうするか
ChatGPT、Claude、GitHub Copilot、Cursorを今のまま使っている人は、この発表で何かを変える必要はない。変わるのは、エージェント用のAPIを自分で組んでいる人や、安い選択肢を探している開発チームの見える景色だ。
⚠ 試す前に確かめること
LongCatのAPIは、Meituanが運営するサービスです。社内のコードや顧客情報を送る前に、データの保存期間、学習への利用の有無、提供地域を、同社の利用規約で確かめてください。この点は、発表の本文からは確認できていません。まずは公開しても差し支えないコードや、ダミーのデータで試すのが安全です。
💡 比べるなら「1タスクの費用」で
単価の安さだけでは判断できません。いま使っているモデルで通っている実際の課題を5〜10件選び、同じ指示でLongCat-2.5にも流して、完了した数、やり直しの回数、使ったトークンの合計を並べてください。単価が4分の1でも、やり直しが4倍なら得にはなりません。
Section 06
編集部の見立て
Editor's Opinion
今回の発表で興味深いのは、性能の主張よりも、出し方の順番です。9月にプレビューを出し、11月に正式化して、数字の表より先に「Opus 5に迫る」という言葉を置きました。まず使わせ、あとで証明する。安い単価は、その入口の役を果たしているように見えます。
読者の側から見て大切なのは、この順番に付き合うかどうかを自分で決められることです。期間限定の価格で試す分には損は小さく、失うのは検証の時間だけです。一方、本番の業務の中心に据えるのは、重みの公開、ライセンス、第三者の測定が揃ってからでも遅くありません。
もう一つ、中国発の大型モデルが国産の計算資源だけで作られ、米国の最上位級に並ぶと主張している点は、モデル選びとは別の文脈でも読めます。ただ、この記事の範囲では、その主張を裏づける測定がまだ出ていないことだけを記しておきます。
Section 07
まとめ
2026年11月2日、MeituanがAIモデル「LongCat-2.5」を公開しました。総パラメータは1.6兆で、1トークンごとに使うのは約480億(約3%)と報じられています。画像と文章を同時に扱い、長時間のコーディングやエージェント作業を狙ったモデルです。
API単価は入力0.30ドル・出力1.20ドル(100万トークン、期間限定)で、GPT-6.1 Terraの標準価格に対して出力は約4分の1です。Claude Code、Codexなど既存のエージェント実行環境に差し込んで使えるとされています。
一方で、重みの公開は予定止まりで日付とライセンスは未定、Claude Opus 5に迫るという比較は図の画像だけで、第三者の測定もありません。データの扱いも、利用規約で確かめる段階です。
次に確かめたいのは、Hugging Faceに重みが載るとき、ライセンスがどう書かれているかと、独立した測定機関の指数にLongCat-2.5が入るかどうかだ。期間限定の1.20ドルが終わる日も、まだ誰も知らない。