Microsoftが10月9日、「Microsoft-Decision-1」というモデルを公開した。文章を1文字も返さない。こちらが並べた選択肢それぞれに、どれくらい確からしいかの数字を返すだけのモデルである。
値札は入力100万トークンあたり0.042ドルで、出力は無料。この数字には先例がある。9月に出たTypeSafeの「Jev」が入力0.042ドル・出力無料で、1セント単位まで同額だ(Jevの中身は9月の記事で扱った)。
そして同じ10月9日、CloudflareがClef-flashの入力単価を0.090ドルから0.038ドルへ下げた。Jevの下にも、Microsoftの新顔の下にも潜り込む値札である。ただし引き換えがあった。ホストされたClef-flashが受け取れる入力の上限が、64,000トークンから24,000トークンへ縮んでいる。安くなった分は、扱える量を削って作られていた。
⚠ 情報の鮮度について
一次情報はMicrosoft公式の告知(2026年10月9日)とCloudflare公式チェンジログ(同日)で、公開時点で約60時間が経過しています。速報ではなく、2つの値札が同じ日に動いたことの意味づけとして読んでください。本文の単価はすべて開発者向けAPIの公表価格で、ChatGPTやClaudeの月額プランの価格ではありません(この違いは第5章で整理します)。他社の単価は2026年10月12日時点の公表値です。
Section 01
10月9日に動いた2つの値札
まず、ここで扱う「判断モデル」が何なのかを押さえておきたい。文章を書くAIは、質問に対して文を生成する。トークンとは、AIが文章を処理するときの単位で、日本語なら1文字が1〜2トークン前後に相当する。生成した文の長さに応じて出力の料金がかかるのが、これまでの値付けだった。
判断モデルは文を作らない。「この問い合わせは返品の話か、配送の話か、それ以外か」のように選択肢を先に渡すと、それぞれの確からしさを数字で返す。返すのが数字だけなので出力トークンがほとんど発生せず、各社そろって出力を無料にしている。振り分け、分類、優先順位づけ、できあがった答えの採点——AIを組み込んだ仕組みの中で、人の目に触れないまま大量に走る処理が、この用途にあたる。
| 10月9日に動いたもの | 内容 | 一次情報 |
|---|---|---|
| Microsoft-Decision-1 | 判断モデルを新規公開。入力100万トークン0.042ドル・出力無料。Microsoft FoundryとOpenRouterで利用可 | Microsoft公式告知 |
| Clef-flash | 入力単価を0.090ドルから0.038ドルへ引き下げ(約58%引き)。ホストされた文脈上限は64,000から24,000トークンへ | Cloudflare公式チェンジログ |
| Clef-omni | 音声と動画も受け取る判断モデルを追加。入力0.150ドル。30BのMoE構成で活性パラメータは3B | Cloudflare公式チェンジログ |
| Clef(上位) | 値段は0.240ドルで据え置き。配信側の最適化で最大2倍速くなったとされ、重みは変えていない | Cloudflare公式チェンジログ |
0.038ドル
Clef-flashの新しい入力単価(0.090ドルから)
24,000
Clef-flashのホスト側の文脈上限(トークン)
0.042ドル
Microsoft-Decision-1の入力単価。Jevと同額
一言でまとめると──「判断1回の値段はまだ下がるが、下がった分は文脈の上限や土台のモデルから持ち出されている」。表の単価だけを並べて最安を決めると、条件の外で順番が入れ替わります。
Section 02
Clef-flashの料金はなぜ0.038ドルになったのか
Cloudflareの公式チェンジログは、値下げと上限の縮小を同じ文の中で説明している。入力単価は0.090ドルから0.038ドルへ。ホストされたClef-flashが扱える文脈は64,000トークンから24,000トークンへ。そして、その判断の根拠として入力が24,000トークンを超える要求は全体の0.24%だったという利用実績を挙げている。Clefの系列そのものは10月1日に出たばかりで、8日後に、その中の最安モデルの値札が書き直されたことになる。
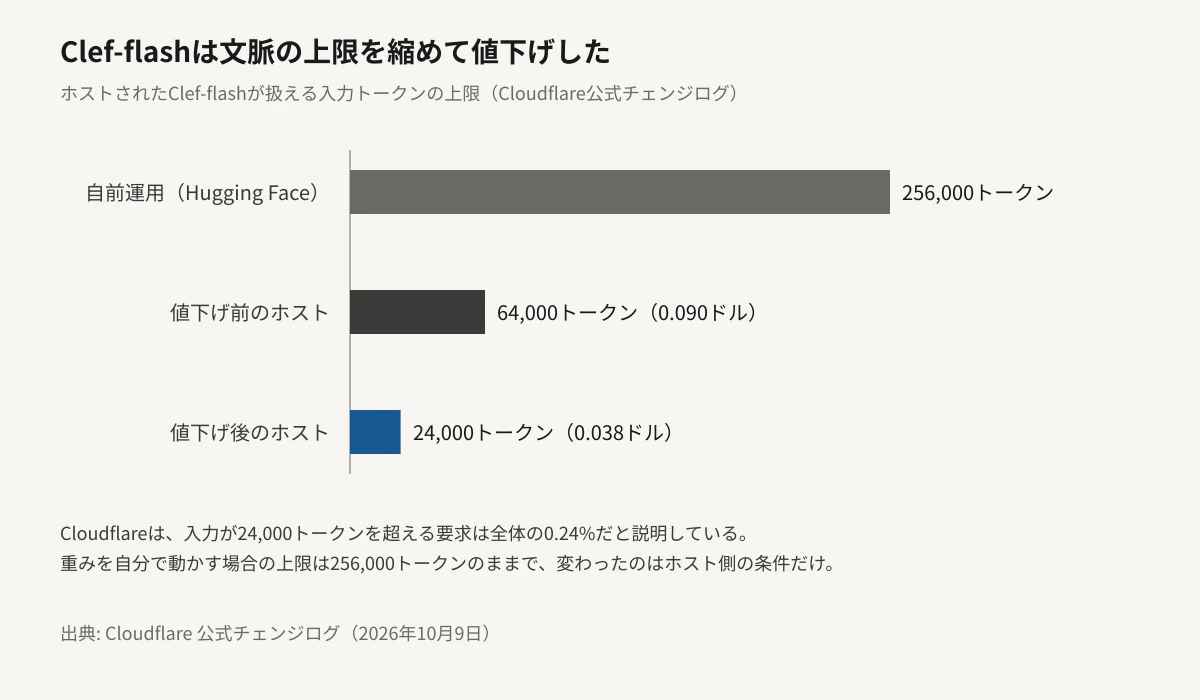
この0.24%という数字の置き方が、今回の値下げの性格をよく表している。全体の0.24%にあたる要求を切り捨てる代わりに、残りの99.76%の単価を6割近く下げたという取引である。多数にとっては純粋な値下げで、少数にとっては使えなくなる変更だ。上限を超える入力が必要なら、同じ系列の上の方へ移ることになる。64,000トークンを扱えるのはClef(0.240ドル)とClef-omni(0.150ドル)で、どちらも0.038ドルの約4倍から6倍にあたる。24,000トークンの壁を1トークン超えた時点で、支払いは数倍に跳ねる。
ⓘ 重みを自分で動かす場合は上限が変わらない
Clefは重みが公開されている系列で、Hugging Faceに置かれたClef-flashの重みは今回変わっていません。自前で動かす場合の上限は256,000トークンのままです。つまり縮んだのはCloudflareがホストしている側の条件だけで、モデルそのものの能力ではありません。自社のサーバーやGPUで動かせる体制があるなら、上限の制約は受けずに済みます。
ついでに言えば、同じチェンジログで追加されたClef-omniは、テキストに加えて画像・音声・動画を1回の要求で受け取る。単価は0.150ドルで、Cloudflareによればテキストなら約20ミリ秒、画像や音声なら100ミリ秒未満、音声付き21秒の動画でも約300ミリ秒で返るという。判断モデルは「文字だけの分類器」から、音や映像を見て決める用途へ広がりはじめている。
Section 03
Microsoft-Decision-1とは何か
Microsoft側の告知を書いたのは、同社CTO室のソフトウェアエンジニアリング担当バイスプレジデントであるAchint Srivastava(アチント・スリバスタバ)氏である。用途として挙げられているのは振り分け・分類・優先順位づけ・検証・処理の流れの制御で、はい/いいえ、多肢選択、点数づけのほか、AIの回答やエージェントの動作を採点基準に照らして採点させることもできるという。
目を引くのは土台だ。Microsoft-Decision-1はAlibabaが重みを公開しているQwen3.5-9Bを後学習して作られている。自社のMAIでもなく、出資先のOpenAIのモデルでもない。しかも同じ告知の中で、近いうちにMAIやOpenAIを含む別のモデルへ土台を載せ替えると予告している。
入力トークンは100万トークンあたり0.042ドル。出力トークンは無料。
— Microsoft公式告知より(2026年10月9日)
性能についてMicrosoftが挙げている数字は、次のとおりである。読み方に注意が要るものも混じっている。
01
速さ:P50でGPT-6 Solの35倍
応答時間の中央値が、2位だったH2O-Lightning-4B v1.1の2.5倍速く、GPT-6 Solの35倍速いとしている。比較対象として名前が挙がっているのはQuyet-1.0-Large、Surogate Rune 26B-A4B、GPT-6 Luna Decisions、deck-31B、H2O-Lightning-4B、Strands-Decider 2Bの6つ。
02
精度:36種・約15万問で首位(自社計測)
学習から外した36のベンチマーク、合わせて約15万問で最も高い精度だったとしている。ただし個別のベンチマーク名ごとのスコアは公開されていないので、第三者が同じ条件で追試できる形にはなっていない。
03
ぶれにくさ:言い換えで判断が変わるのは1.3%
同じ内容を8通りに言い換えて投げたとき、判断が変わったのは平均1.3%。選択肢の説明を言い換えた場合と、選択肢の順序を逆にした場合・並べ替えた場合には、1件も変わらなかったとしている。安全性の試験は11のベンチマーク・5,250件の要求で行ったという。
社内での使用例も3つ挙がっている。Xbox Researchが1万件を超える自由記述のフィードバックを分類した例では、品質はGPT-6 Solと張り合えて、14倍速く・費用は200分の1だったという。Copilotの開発チームでは回答の品質管理に使い、GPT-5.6 Lunaと張り合える品質で100倍速いとしている。科学探索の基盤Microsoft Discoveryでは、大規模言語モデルに採点させるやり方より46倍一貫していたという。いずれもMicrosoftの自社計測で、第三者の検証は見つかっていない。※観測として読むのが妥当だろう。
⚠ 「いまの0.042ドル」が何の値段なのかは、半分しか決まっていない
公式の告知には、Foundryでの提供が試験公開なのか正式提供なのかが書かれていません。二次報道は「公開プレビュー」と「正式提供」に割れています。加えて、土台をMAIやOpenAIへ載せ替える予告が同じ文書に入っています。同じ名前で呼び出していても、中身が入れ替わる前提の値札だと考えて、本番の処理に組み込む前に提供状態をFoundryの表示で確かめてください。
Section 04
最安は、もう表の単価では決まらない
ここが本題である。0.038ドルと0.042ドルの差は1割弱で、どちらを選ぶかは単価表を見れば決まる——ように見える。実際には、条件を1つ開けるだけで順番が入れ替わる。
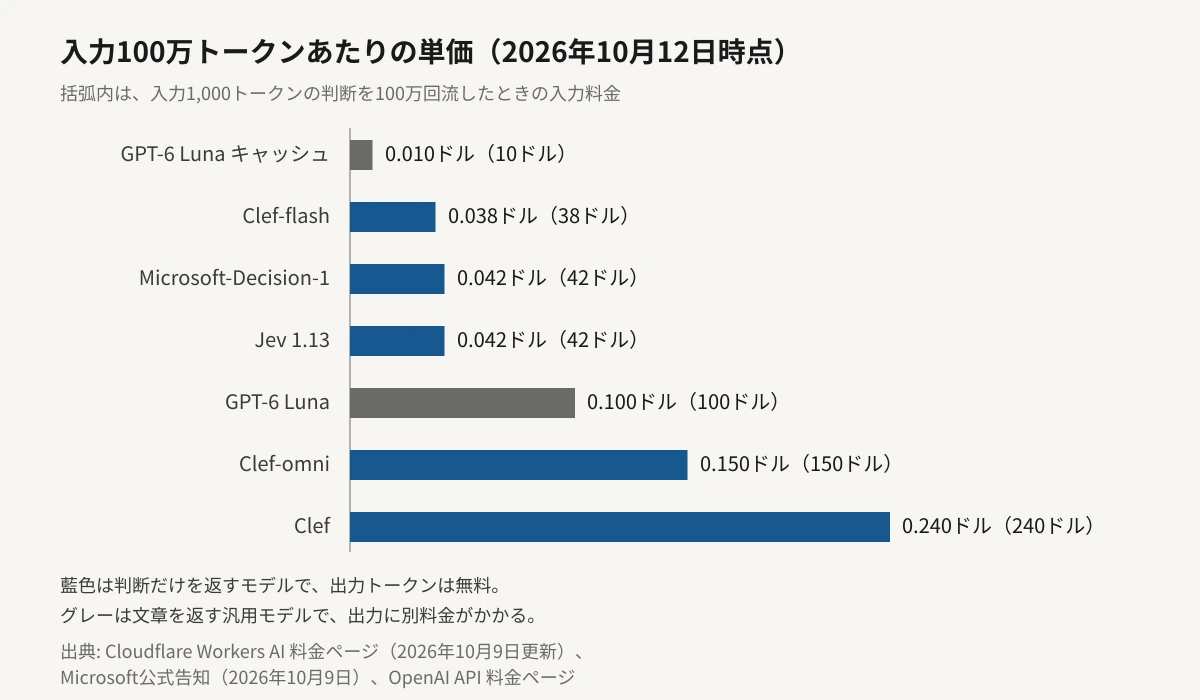
比べる相手として、汎用の最安モデルを置いてみる。OpenAIのGPT-6 Lunaは、公式の料金表で入力100万トークン0.10ドル・出力0.50ドルである。入力1,000トークンの判断を1回させると0.0001ドルほどで、出力が5トークン出るとしても合計0.0001025ドル。Clef-flashの0.000038ドルに対して約2.7倍になる。ここまでは判断モデルが安い。
ところがLunaにはキャッシュ済み入力0.01ドルという段がある。同じ前置きを何度も送り直す使い方なら、1回あたり0.0000125ドルまで下がり、こちらはClef-flashの約3分の1になる。振り分けの処理は、長い判定ルールを前置きにして毎回同じ文面を送る形になりやすい。つまり「同じ文脈を繰り返すか」という1点で、判断モデルと汎用モデルのどちらが安いかが裏返る。
| 確かめる条件 | 判断モデル側 | 汎用の最安モデル側 |
|---|---|---|
| 入力100万トークンの単価 | Clef-flash 0.038ドル/Decision-1・Jev 0.042ドル | GPT-6 Luna 0.10ドル/Claude Haiku 5.5 0.10ドル |
| 出力の料金 | 無料(3モデルとも) | GPT-6 Luna 0.50ドル/Claude Haiku 5.5 0.50ドル |
| キャッシュ済み入力 | 公表された単価は見つからない | GPT-6 Luna 0.01ドル/Claude Haiku 5.5 0.01ドル |
| 長い入力で単価が上がる境目 | Clef-flashは24,000トークンで上限(受け付けない) | GPT-6 Lunaは27万2,000トークン超で0.20ドル/Claude Haiku 5.5は10万トークン超で0.50ドル |
| 返ってくるもの | 選択肢ごとの確からしさの数字 | 文章。判断の理由も書かせられる |
Claudeの側にも同じ形の段がある。10月7日に出たHaiku 5.5は入力10万トークンまで0.10ドル・出力0.50ドルで、1回の入力が10万トークンを超えると入力0.50ドル・出力2.50ドルへ上がる(詳しくはHaiku 5.5の記事で扱った)。GPT-6 Lunaの境目は27万2,000トークン超で、そこから入力0.20ドルになる。Clef-flashは境目を作る代わりに、上限そのものを24,000トークンに引いた。
3社のやり方は違うが、向かっている先は同じだ。安い単価は「短い入力」に対して提示されており、長くなった瞬間に別の値段か別のモデルへ移される。単価表の一番上の数字だけを比べても、自分の使い方がどの段に落ちるかは分からない。
Section 05
あなたの請求書と、移す前に測るもの
ここまでの金額はすべて開発者向けAPIの公表価格である。日常的にAIを使っている人にとって、どこが変わってどこが変わらないのかを分けておきたい。
A
月額プランを使っている人:変わらない
ChatGPTやClaudeの月額プランの価格は今回動いていない。判断モデルは画面から使う製品ではなく、APIで組み込む部品である。Microsoft-Decision-1もClef-flashも、申し込み画面を持つ製品としては提供されていない。
B
分類や振り分けを自作している人:下げ幅が大きい
問い合わせの振り分け、文書の仕分け、回答の自動採点を汎用モデルで回しているなら、置き換えの候補が1つ増えた。前置きが短く、選択肢が決まっている処理ほど移しやすい。ただし移す前に、下の計算を一度やっておきたい。
C
ツール経由で使っている人:すぐには変わらない
GitHub CopilotやCursorのように複数のモデルを使い分けるツールでは、仕入れ値の変化がそのまま利用者の料金に降りてくるとは限らない。降りてくるとしても時間差がある。
💡 移す前に測る3つ
1つめは入力の長さの分布です。いまの処理で送っている前置きと本文の合計が、24,000トークンを超える割合を数えてください。Cloudflareは全体の0.24%だと言っていますが、それは同社の利用実績であって、あなたの処理の分布ではありません。2つめは同じ前置きを何度送っているかです。繰り返しが多いなら、キャッシュ済み入力を持つ汎用モデルのほうが安く収まる場合があります。3つめは判断の理由が要るかどうかです。判断モデルは数字しか返さないので、「なぜそう分類したか」をログに残す運用なら、そのままでは置き換えられません。
この層の値段の動き方も見ておきたい。9月のJevの0.042ドルが、1か月足らずで0.038ドルに下回られた。一方でMicrosoftは下回りにいかず、Jevと同額に並べた。価格で勝負していないということは、速さと精度で選ばせるつもりだということでもある。0.038ドルと0.042ドルの差は1割弱まで詰まっていて、ここから先の値下げが請求書を動かす幅は小さい。
Section 06
編集部の見立て
Editor's Opinion
今回いちばん気になったのは、0.038ドルという数字の低さではなく、その作り方です。Cloudflareは値下げの理由を隠していません。扱える文脈を64,000トークンから24,000トークンへ縮め、超える要求は全体の0.24%だと添えて、残りの単価を下げました。開示の仕方としては誠実です。ただ、同じ論法が繰り返されたらどうなるかは考えておきたいところです。「ほとんどの人は使っていない範囲」を切り落として値札を下げるやり方は、何度でも使えます。
Microsoft側の予告も、同じ方向から読めます。Qwen3.5-9Bという他社の公開モデルを土台に使い、近いうちにMAIやOpenAIへ載せ替えると最初から書いてあります。値段と名前を先に固定して、中身を後から入れ替えるという順序です。利用する側からすると、名前と値段が変わらないのに挙動が変わる可能性を抱えることになります。採点や振り分けのような、結果が静かに業務へ流れていく処理ほど、この入れ替わりは気づきにくいはずです。
読者にとっての実務的な意味は、はっきりしていると考えます。この層のモデルを比べるとき、見るべきものが単価から条件へ移りました。文脈の上限、キャッシュの単価、長さの境目、そして土台が入れ替わる予告があるかどうか。どれも価格表の見出しには出てきませんが、請求書と出力の安定性には、そのままはね返ってきます。
そのうえで、判断モデルという層そのものは定着したと見ています。文章を返さないモデルに値札が付いたのは9月半ばのことでした。それから1か月のあいだに、Cloudflareが系列をまるごと公開して8日後に最安値を書き直し、Microsoftが自社の製品棚に並べ、音声と動画まで受け取るものが出てきました。この速さは、需要が先にあった場所にしか起きません。
Section 07
まとめ
2026年10月9日、Microsoftが判断モデル「Microsoft-Decision-1」を公開しました。入力100万トークン0.042ドル・出力無料で、9月に出たTypeSafeのJevと同額です。土台はAlibabaが公開しているQwen3.5-9Bを後学習したもので、同社は近いうちにMAIやOpenAIのモデルへ載せ替えると予告しています。
同じ日、CloudflareはClef-flashの入力単価を0.090ドルから0.038ドルへ下げました。その引き換えに、ホストされた文脈の上限が64,000トークンから24,000トークンへ縮んでいます。同社は、入力が24,000トークンを超える要求は全体の0.24%だと説明しています。重みを自前で動かす場合の上限は256,000トークンのままです。
速さと精度についてMicrosoftが挙げた数字(P50でGPT-6 Solの35倍、36種・約15万問で首位、言い換えで判断が変わるのは1.3%)は、いずれも自社計測で第三者の検証は見つかっていません。※観測として扱うのが妥当です。Foundryでの提供が試験公開なのか正式提供なのかも、公式の告知には書かれていません。
比べ方の結論としては、単価表の見出しだけでは最安が決まらない、という一点に尽きます。GPT-6 Lunaはキャッシュ済み入力が0.01ドルで、同じ前置きを繰り返す処理ではClef-flashの約3分の1になります。Claude Haiku 5.5は10万トークン、GPT-6 Lunaは27万2,000トークンで段が上がります。ChatGPTやClaudeの月額プランの価格は動いていません。
次に見るべき値札は、Microsoftが予告した載せ替えのあとの0.042ドルである。土台がQwen3.5-9Bから自社のMAIやOpenAIのモデルへ替わったとき、同じ値段のままなのか。判断の安さが他社の公開モデルの安さで成り立っているなら、載せ替えた日に値札が動く。