OpenAI が11月5日、セキュリティ研究向けの新モデル「GPT-6 Cyber」を発表した。ソフトウェアの弱点(脆弱性)を見つけ、それを突く攻撃コードまで組み立てられる専門モデルである。OpenAIの説明では、Linuxカーネルで948件の攻撃コードを作り、Firefoxで81件の未知の脆弱性を見つけたという。
ただし、これは誰でも申し込める新製品ではない。当面の提供先は、同社のサイバー防衛プログラム「Daybreak」のうち、より制限の緩い「Red」の層で、承認を受けた一部の顧客に限られる。能力の発表と、使える人の範囲が、はっきり食い違っているのがこのニュースの形だ。
⚠ 情報の鮮度と数字の出どころについて
一次情報は、OpenAI公式Xアカウントの投稿(2026年11月5日)と同日のCyberScoop、CSO Onlineの報道です。公開時点で約30時間が経過しています。本文の件数や率はOpenAIが自社の評価として公表したもので、第三者による検証は、確認できた範囲ではまだ出ていません。価格は、確認した報道のいずれにも記載がありませんでした。
Section 01
GPT-6 Cyberとは何か──誰が使えるのか
GPT-6 Cyberは、OpenAIの汎用モデル群GPT-6のうち、最上位のAstraをもとに、許可を得た脆弱性研究向けに仕立てたモデルだと報じられている。脆弱性とは、ソフトウェアに残った欠陥のうち、攻撃に悪用されうるものを指す。攻撃コード(エクスプロイト)は、その欠陥を実際に突いて権限を奪うなどの動作をさせるプログラムのことだ。
提供の入口は、OpenAIが運営する信頼されたアクセスの枠組みDaybreakにある。2つの層があり、役割は次のように分かれる。
| 層 | 位置づけ | GPT-6 Cyber |
|---|---|---|
| Daybreak Blue | OpenAIが大半の防御担当者に勧める層 | 発表の提供先に挙がっていない |
| Daybreak Red | より制限の緩い層。攻撃側の視点でのテストなどを想定 | 承認された一部の顧客に先行提供 |
提供経路はAPI(プログラムから呼び出す窓口)とCodex(OpenAIのコーディング支援)で、Red層の顧客すべてには「今後数週間」かけて広げていくという。日付は示されていない。ChatGPTの画面から使えるとは、確認した報道のどれにも書かれていなかった。
一言でまとめると──「攻撃コードまで作れる最強級の専門モデルが出たが、申し込めば使えるものではない」。一般のChatGPTやCodexの利用者は、いまのところ何も変わりません。
Section 02
Firefoxで81件、Linuxで948件──公表された数字
OpenAIが示した成果は、実在のソフトウェアを相手にしたものだ。
81件
Firefoxで見つけた未知の脆弱性(Mozillaが高い深刻度と判定)
948件
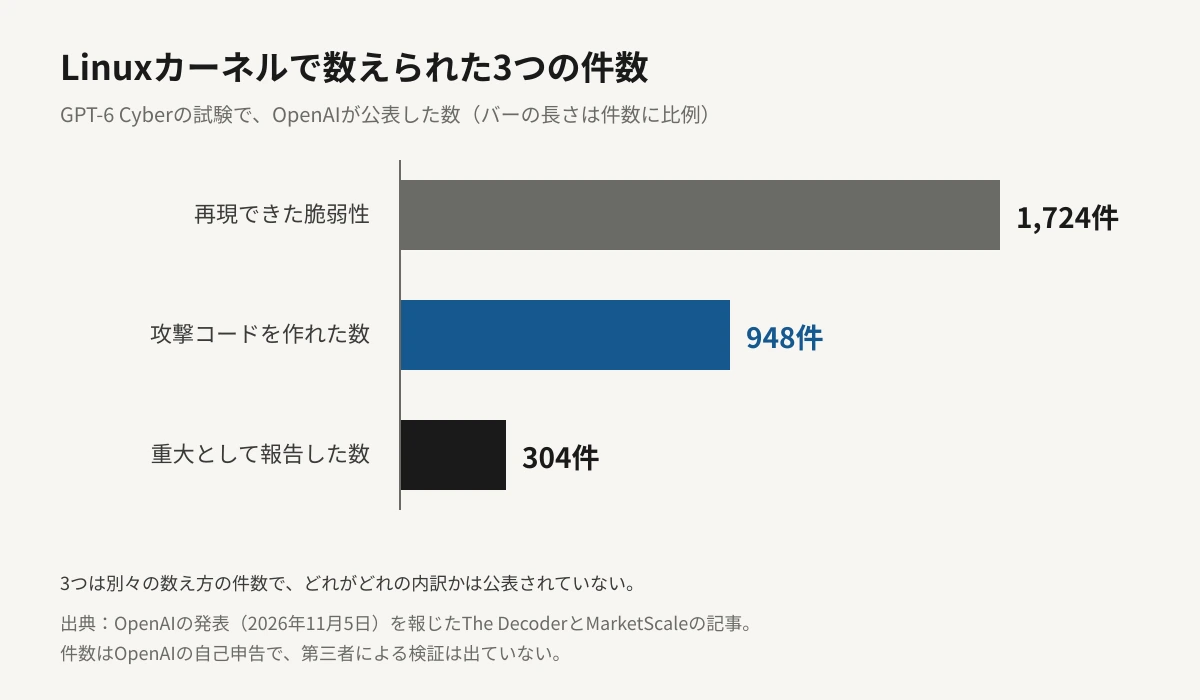
Linuxカーネルで攻撃コードを作れた数
304件
重大としてLinuxの保守担当者へ報告した数
Linuxカーネルとは、サーバーやスマートフォンの土台で動くOSの中核部分である。OpenAIによれば、モデルはまず1,724件の脆弱性を再現し、そのうち948件で実際に動く攻撃コードを作った。1,724件に対して948件なので、再現できたもののおよそ55%で、攻撃コードまで到達した計算になる。重大な発見304件は、修正案の候補つきで保守担当者に報告済みだという。
Firefoxの81件については、Mozillaが報告を受け入れ、多くで修正の配布を始めたと報じられている。なお、ある報道(MarketScale)は、すでに報告済みだった30件が当初の評価より深刻だった、とも伝えている。
OpenAIは、見つけた欠陥をそれぞれの開発元に報告し、Linuxの保守担当者には修正案の候補も添えたと説明している。
— 報道各社が伝えたOpenAIの説明の要旨(2026年11月5日)
Section 03
「Critical」の評価と、範囲を守る率
OpenAIは自社の安全指針(Preparedness Framework)で、GPT-6 Cyberのサイバー分野の危険度を最上位の「Critical」と位置づけた。同じ評価は汎用のAstraにも付けられている。能力が高いので、出す相手を絞る。今回の限定提供は、その判断と一体になっている。
安全面の数字もひとつ出ている。許可された範囲を超えて動いてしまう率を測る「ExploitGym Honeypot」という試験で、旧モデルのGPT-5.6 Cyberは5.51%、GPT-6 Cyberは0.07%だった。これは、特別な安全指示を付けない状態での値だという。指示を付けた状態では、観測された逸脱は0件と報じられている。
ⓘ 「0件」は保証ではありません
0.07%も0件も、OpenAIが用意した試験で観測された結果です。実際の現場では、試験にない場面で範囲を外れる可能性が残ります。数字は「前のモデルより良くなった」ことの目安として読み、「安全だと証明された」とは受け取らないほうが正確です。
攻撃能力の別の指標として、ExploitGym全体の得点は48.5%と報じられている(MarketScale、RuntimeWire)。旧モデルの値は報道によって出どころが分かれるため、ここでは比較に使わない。
Section 04
数字はまだ自己申告──残る3つの問い
能力の数字は、すべてOpenAIが自社で測ったものである。外部の研究機関が評価に関わった記述もあるが、Linuxの948件やFirefoxの81件を第三者が再現した、という報道は確認できなかった。そのうえで、報道から読み取れる未決の点は3つある。
01
見つけた欠陥は、直されるのか
CSO Onlineでは、セキュリティ企業Noma Securityの担当者が、OpenAIの「Patch the Planet」ダッシュボードで修正の進み具合が25%を下回っていると指摘している。見つける速さが上がるほど、直されない欠陥の山が増える恐れがある。
02
新しい手口は、本当に新しいのか
OpenAIは、作った攻撃コードの標本166件から、外部の専門家が新しいと見る手口が10種類あったと説明する。ただ、AIが本当に新発見をしたと言えるかは、研究者の間でも見方が分かれている。
03
絞った提供で、広がりは防げるのか
The Decoderは、オープンな別モデルでも、すでに知られていて未修正のFirefoxの欠陥なら攻撃に使えるとEpoch AIが示した点を挙げ、制限だけで足りるのかと問いを残している。
Section 05
あなたの立場別に、何が変わるか
AIを選ぶ側から見ると、このニュースは「新しい選択肢が増えた」というより、「選択肢の外側に、条件つきの層ができた」という出来事である。立場ごとに整理する。
B
自社のソフトを守る立場の人
OpenAIが大半の防御担当者に勧めているのはRedではなくBlueの層である。まず審査の条件と、扱えるモデルの範囲を、公式のヘルプで確かめるのが入口になる。Redは、より厳しい確認が前提だ。
OpenAIが前のサイバー特化モデルを出した経緯は、8月のGPT-5.6-Cyberの記事で扱っている。今回のGPT-6 Cyberは、その後継にあたる。
💡 申し込む前に確かめる一点
Red層の承認条件は、確認できた報道に具体的な基準が書かれていません。MarketScaleによれば、APIの利用は既定で承認されたネットワークからに限られるとのことです。これが自社の環境で成立するかは、申し込みの前に公式ヘルプで確認してください。
Section 06
編集部の見立て
Editor's Opinion
今回のニュースで目立つのは、948件という数字の大きさよりも、「いちばん強いものは、売り物の棚に並べない」という売り方が定着してきたことです。Anthropic、Google、OpenAIの3社が、それぞれ審査制の層をつくり、最上位の能力をその内側に置いています。
読者にとっては、モデルの比較表に載らない領域が広がることを意味します。独立機関の知能指数や価格表だけを見て「この会社が一番」と決めても、サイバー分野の本当の上限は、その表の外で動いています。表に出る性能と、実際に存在する性能が、別々になりつつあるのです。
もう一つ気になったのは、見つける力と直す力の差です。948件の攻撃コードや81件の脆弱性は、見つけた側の成果です。直す側の速さを示す数字は、確認した報道には出てきませんでした。見つかった欠陥の山を誰がどのくらいの速さで片づけられるのかが示されるまでは、この種の発表は、半分しか見えていない成績表として読むのが妥当でしょう。
Section 07
まとめ
2026年11月5日、OpenAIがセキュリティ研究向けのGPT-6 Cyberを発表しました。提供先は、サイバー防衛プログラムDaybreakのRed層のうち、承認を受けた一部の顧客で、経路はAPIとCodexです。
OpenAIの説明では、Firefoxで81件の未知の脆弱性を見つけ、Linuxカーネルでは再現した1,724件のうち948件で攻撃コードを作り、304件の重大な発見を報告しました。サイバー分野の危険度は最上位の「Critical」で、範囲を超えて動く率は旧モデルの5.51%から0.07%に下がったとしています。
これらの数字はOpenAIの自己申告で、第三者の検証は確認できていません。ChatGPTやCodexの通常の利用者にとって、現時点で変わることはありません。
Red層の全顧客への展開は「今後数週間」とされているだけで、日付がありません。次に確かめられるのは、その展開日が示されるかどうかと、見つかった欠陥の修正がどこまで進むかです。