ブラウザだけでアプリを作れる開発プラットフォームReplitの最高経営責任者(CEO)アムジャド・マサド氏が、自社主催ではない技術イベント TechCrunch Disrupt の登壇で、同社はもうAnthropicと協業していないと述べた。TechCrunchが米太平洋時間2026年10月16日に報じている。理由として挙げられたのは、料金、提携の条件、そして性能の3つだという。
ところが話は、同じ記事の中でねじれる。提携の事情を知る1人は、名前を出さない条件で「提携はいまも続いている」とTechCrunchに語った。Replit自身が9月29日に公開した技術記事にも、Claude Fable 5.1 が本番のReplit Agentで動いていたことが書かれている。
当事者の説明が食い違っている部分は、外からは決められない。だが確かめられることが1つある。Replitが9月に本番で並べて動かしていた2つのモデル──Claude Fable 5.1 と GPT-6 Astra──の公表単価は、入力10.00ドル・出力50.00ドルでまったく同額なのである。
⚠ 情報の鮮度と、確認できた範囲について
一次情報はTechCrunchの報道(米太平洋時間2026年10月16日)、Replit公式の技術記事(2026年9月29日)、OpenAIとAnthropic両社公式の料金ページ(いずれも2026年10月17日に編集部で原文を確認)です。登壇での発言そのものはTechCrunch Disruptの会期中のもので、本記事の公開時点で約60時間が経過しています。協業が終わったかどうかは当事者の説明が食い違っており、Anthropic側の公式見解は公開時点で確認できていません。本文の価格はすべて開発者向けAPIの公表価格で、ChatGPTやClaudeの月額プランの価格ではありません。
Section 01
Replitは何を語り、どこが食い違っているのか
Replitは、指示を文章で書くとアプリの形になって動き出す種類のサービスだ。裏側では大規模言語モデルが設計とコードを書いており、そのモデルを外部から仕入れている。仕入れ先の筆頭がAnthropicだった、という前提でこの話は始まる。
TechCrunchの報道によれば、マサド氏は決定の理由を「いくつもの理由があった」と説明し、そのうちの1つとして料金を挙げた。性能については、いまはChatGPT側のほうが優れていると語ったと伝えられている。社内のベンチマークと、Replitが公開しているベンチマークの両方で、OpenAIのSolとAstraのほうが、ゼロからアプリを組み上げる仕事では成績が良かったという。OpenAI側を「いまのところはより良い提携先だ」と表現したとも報じられている。
食い違っているのはここからだ。同じ記事で、提携の事情を知る人物が「提携はまだ続いている」と述べている。さらにReplitの公式サイト・ブログ・SNSには、発言の数週間前までAnthropicの製品を使っていた痕跡が残っていた。TechCrunchはReplitに説明を求めており、回答があれば記事を更新するとしている。
痕跡のほうは、Replit自身の記録で確かめられる。9月29日に同社が公開した技術記事「Free the models」には、本番のReplit Agentで1モデルあたり1週間ずつ動かした計測結果が載っている。2026年8月はClaude Fable 5、9月はClaude Fable 5.1とGPT-6 Astraである。部下役のエージェントに仕事を振る割合は、Fable 5が32%、Fable 5.1が21%、Astraが36%。汎用の作業役に投げる割合は、Fable 5が0.9%、Fable 5.1が2.3%に対し、Astraは20%だった。9月の時点でClaudeは、試験ではなく本番で動いていた。
同額
Fable 5.1とGPT-6 Astraの公表単価
9月29日
Claudeが本番稼働していた同社の記録
2%→15%
Replitの売上に占める企業契約(昨年→今年)
一言でまとめると──「料金が理由」と語られた乗り換えですが、両社の公表単価は同額でした。差が生まれる場所は値札そのものではなく、その下にある文脈長・キャッシュ・バッチ・速度という4つの階層と、トークンの数え方のほうです。
Section 02
Claude Opus 5.5とGPT-6.1 Solの料金はどちらが安いのか
トークンとは、AIが文章を処理するときの単位である。日本語なら1文字が1〜2トークン前後に当たる。開発者向けAPIの価格は、この100万トークンあたりの金額で示される。
両社の公式の料金ページを開くと、Replitが9月に並べていた上位の2モデルは、こうなっている。
| 100万トークンあたり | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| 入力(標準) | 10.00ドル | 10.00ドル |
| 出力(標準) | 50.00ドル | 50.00ドル |
| 入力27.2万トークンを超えたとき | 変わらない(10.00ドル/50.00ドル) | 20.00ドル/75.00ドル |
| キャッシュの読み出し | 0.25ドル | 1.00ドル |
| バッチ(非同期)処理 | 50%引き | 50%引き |
| 同じ文章から数えるトークン数 | 約30%多い | 基準 |
標準価格は1円の差もない。それだけでなく、長い入力とキャッシュの読み出しという2つの階層では、Claudeのほうが安い。Fable 5.1は100万トークンの文脈すべてが標準価格で、900万字相当の長文を投げても単価は変わらない。Astraは入力27.2万トークンを超えると入力が20.00ドル、出力が75.00ドルに上がる。キャッシュの読み出しは0.25ドル対1.00ドルで、Claudeが4分の1である。
中位の層でも同じ形が出る。Claude Sonnet 5.5は入力2.00ドル・出力10.00ドル、GPT-6.1 Solも標準で入力2.00ドル・出力10.00ドル。ここも同額で、Solは27.2万トークンを超えると入力4.00ドル・出力15.00ドルに上がり、Sonnet 5.5は全域で変わらない。Claude Opus 5.5は入力4.00ドル・出力20.00ドルで、Solの標準の倍だが、こちらも100万トークンの全域が標準価格だ。
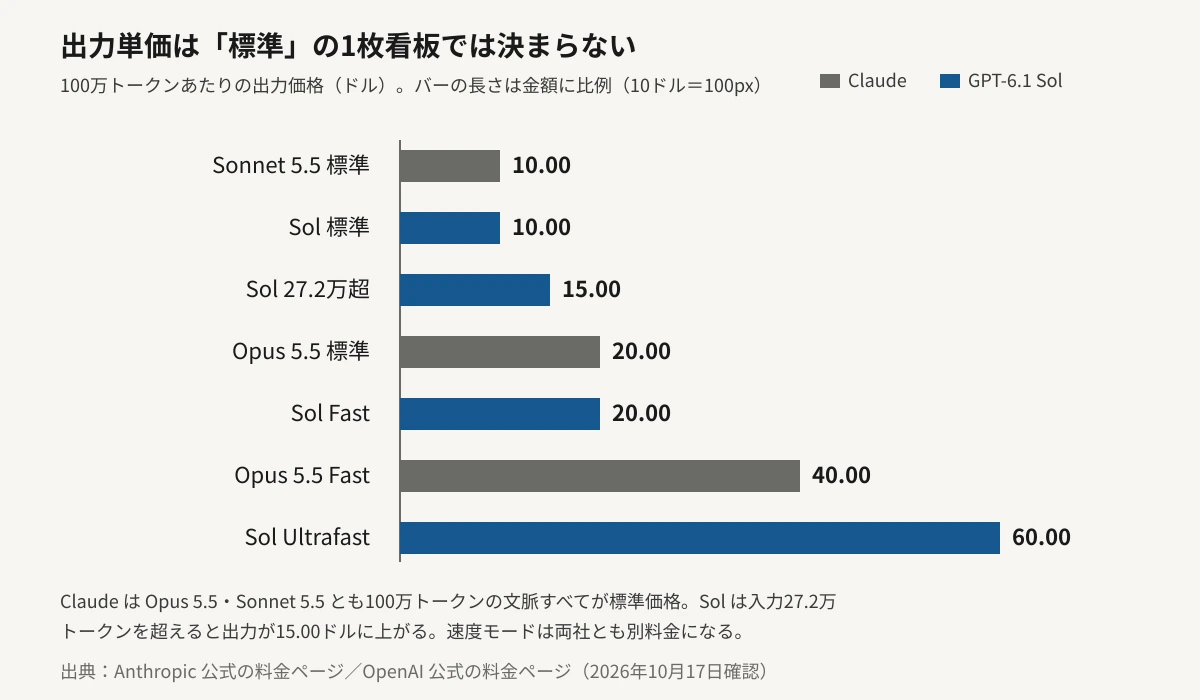
つまり値札の比較だけでは、料金が乗り換えの理由になった筋道は出てこない。少なくとも、公表されている数字を並べるかぎりは出てこない。
Section 03
単価が同じでも請求額が分かれる4つの階層
AIの単価は1つの数字ではない。同じモデル名でも、条件ごとに別の値段が貼られている。両社の料金ページを読み比べると、少なくとも次の4つの階層がある。
01
文脈の長さ
OpenAIは入力27.2万トークンが境目で、超えると単価が上がる。Anthropicは Claude 4.6 以降のモデル(Haiku 5.5を除く)で100万トークンの全域が標準価格。長い会議録や大きなコードベースを丸ごと投げる使い方では、ここで順位が入れ替わる。
02
キャッシュの読み書き
同じ前置きを毎回送る使い方では、2回目以降が割引になる。割引の深さは社ごとに違う。Fable 5.1の読み出しは基本入力の0.025倍で0.25ドル、Astraは0.1倍で1.00ドル。Opus 5.5とSonnet 5.5は0.05倍、Solも0.05倍で0.10ドルだ。
03
バッチ(非同期)
急がない仕事をまとめて流す経路。両社とも入力・出力ともに50%引きで、ここは横並びである。片方だけが得になる階層ではない。「どちらも同じ」も、同じだけ書く価値のある事実だ。
04
速度・優先度のモード
同じモデル名の設定違いに見えて、実際は別料金になる。Opus 5.5のFastモードは入力8.00ドル・出力40.00ドルで標準の2倍。SolはFastが入力4.00ドル・出力20.00ドルで2倍、Ultrafastが入力12.00ドル・出力60.00ドルで6倍である。
ⓘ 「安い」は使い方で裏返ります
短い指示をたくさん投げる使い方では、標準価格の差がそのまま請求額の差になります。一方で長いコードベースを丸ごと読ませる使い方なら、27.2万トークンの境目を踏むかどうかのほうが大きく動きます。同じ前置きを繰り返し送る使い方では、キャッシュの読み出し単価が主役になります。自分の仕事がどの階層に当たるかを知らないまま「どちらが安いか」を調べても、答えは出ません。
Section 04
Claudeのトークナイザは同じ文章を約30%多く数える
4つの階層を全部そろえても、まだ説明しきれない差が1つ残る。トークンの数え方そのものだ。
Anthropicは料金ページに、Claude 4.7以降のモデルとClaude Mythos Previewが新しいトークナイザを使っており、同じ文章から約30%多いトークンを生むと書いている。性能の向上に寄与する変更だという説明も添えられている。増え方は内容と仕事の形で変わるとも明記されている。Claude Sonnet 4.6までは従来のトークナイザだ。
単価が同じでも、数えられる量が3割増えるなら、同じ仕事の請求額はその分だけ上がる。出力10.00ドルのモデルで100万トークン分の仕事なら10.00ドル、同じ文章が130万トークンと数えられれば13.00ドル相当になる計算だ。
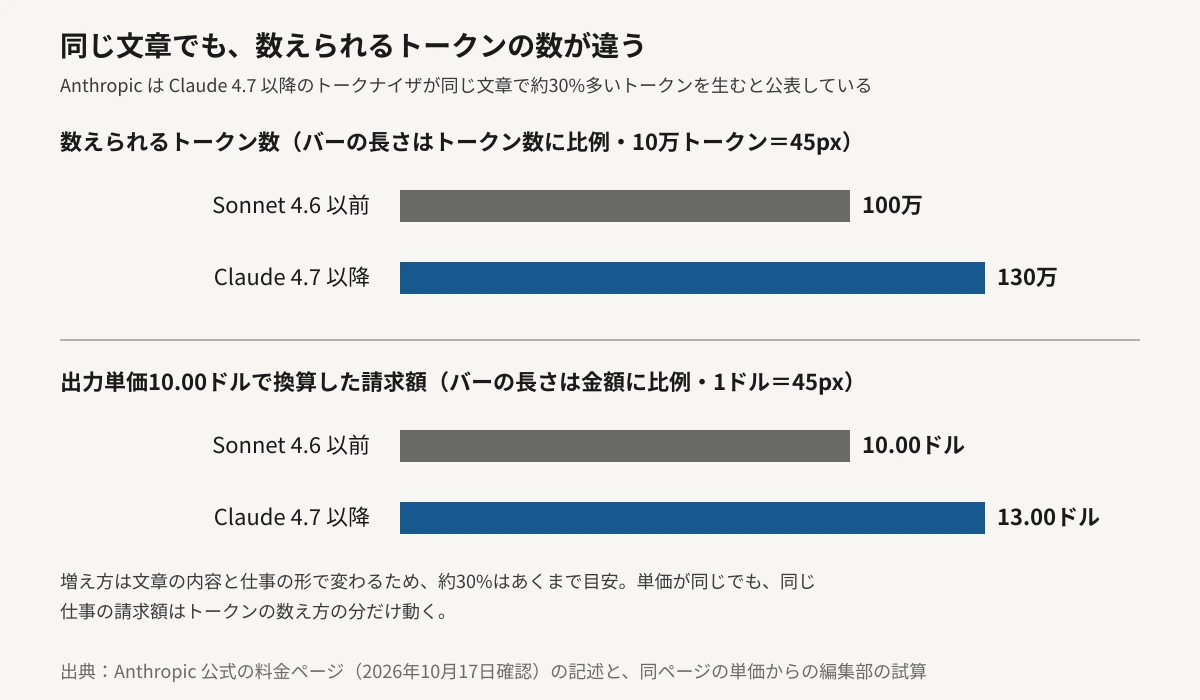
この換算は料金ページの記述と単価からの試算であり、Anthropicが請求額の差として公表している数字ではない。実際の増え方は扱う文章によって上下する。それでも値札の比較に出てこない差が、値札の下に実在することは、同社自身の記述から読み取れる。
Replitが挙げたもう1つの理由、提携の条件のほうは、外からは検算できない。大口の利用者が結ぶ契約には、公表価格とは別の単価や最低利用額、計算資源の確保といった条件が入るのが普通だ。公表されている値札が同額なのに料金が理由になりうるとすれば、差があったのはそちら側だと考えるのが自然だろう。ただしこれは推測であり、両社のどちらも契約の中身を明らかにしていない。※観測
Section 05
Replitの料金プランにモデル名が書かれていない意味
ここまでは仕入れ側の話である。では、Replitを使ってアプリを作っている人の請求書は、どう関わるのか。
Replitの料金ページを開くと、個人向けはCoreが月20ドル(年払いなら月18ドル相当)、Proが月100ドル(年払いなら月90ドル相当)で、企業向けは個別見積もりだ。Coreには「より強力なモデルに使える20ドル分」、Proには「最上位のモデルに使える100ドル分」が含まれると書かれている。使い方に応じた課金とクレジットという仕組みもある。
そして、この料金ページにはモデル名が1つも書かれていない。「Replit Agentは大規模言語モデルで動いています」という説明だけだ。Agentの公式ドキュメントも同じで、Free Mode・Auto・Power・Maxというモードと「賢いモデル振り分け」が説明されているが、どのモデルかは書かれていない。Power時に使える高速化のつまみについては「最速のモデル、最大2.5倍の速度で6倍の費用」とだけ記されている。
つまり仕入れ先が入れ替わっても、使う側の画面と請求書には何も表示されない。これはReplitに限った話ではなく、上流のモデルを仕入れて自社の単位で売り直すサービスに共通する構えだ。9月には法務AIのHarveyが、粗利率の悪化を受けてフロンティアAPIから離れたと報じられている(詳しくはHarveyの粗利率が約50%からマイナス50%に落ちたという報道に書いた)。仕入れの経済が動けば、売り手の中身も動く。
A
Replitのような一体型を使っている人
価格表は当面変わらない見込みだが、出来上がるコードの癖は変わりうる。同じ指示で前と違う形のものが出てきたら、裏側が入れ替わった可能性を考える手がかりになる。保存した作例を何本か決めておき、ときどき同じ指示で流して比べるのが確かめ方だ。
B
モデル名が見えるツールを使っている人
GitHub CopilotやCursorのように、どのモデルで動かすかを自分で選べるツールなら、入れ替えは画面に出る。引退の予告も出る。選べることの価値は、速さや賢さではなく、こうした変化が見えることのほうに出る。
C
自分でAPIを直接叩いている人
今回の話は仕入れ条件の話なので、公表価格は動いていない。ただし上の4つの階層とトークンの数え方は、そのまま自分の請求書に当たる。27.2万トークンの境目とキャッシュの読み出し単価は、いまの使い方で一度確かめる価値がある。
⚠ 乗り換えの報道を自分の判断に移す前に
「大手が離れた」はモデルの優劣の証明ではありません。マサド氏が挙げた成績は、ゼロからアプリを組み上げるというReplitの仕事に合わせた社内ベンチマークの結果です。あなたの仕事の形が違えば、順位も変わります。同じ理由で、公表単価の比較もあなたの請求書の予告にはなりません。自分の使い方で20〜30件ほど同じ入力を流し、トークン数と結果を並べて見るほうが、どの報道より確かな材料になります。
Section 06
編集部の見立て
Editor's Opinion
この件でいちばん情報量が多いのは、乗り換えたという話のほうではないと考えます。料金を理由に挙げた乗り換えが、両社の公表単価では説明できなかった、という事実のほうです。
AIの値段は、これまで「100万トークンいくら」という1行で語られてきました。記事も比較表もその1行で書かれています。けれども実際の請求額は、文脈の長さ、キャッシュ、バッチ、速度モード、そしてトークンの数え方という何層かを通った先で決まります。今回のように、1行の値札が同額でも乗り換えが起きる場面が出てくると、その1行で比べていたことの限界がはっきりします。
もう一点、当事者の説明が食い違ったままである点も記録しておきたいと考えています。CEOが公の場で終了を語り、関係者が継続を語り、同社自身の技術記事には9月の本番稼働が残っている。どれかが嘘だと決めつける材料は、いまのところありません。契約が段階的に縮んでいる途中なら、見ている場所によって答えが変わることもありえます。
読者の側で動かせることがあるとすれば、それは自分が使っているツールについて「中で何が動いているか書かれているか」を一度見ておくことだと考えます。書かれていないツールは悪いツールではありません。ただ、裏側が入れ替わったとき、気づく手がかりが出力の変化だけになります。
Section 07
まとめ
2026年10月16日(米太平洋時間)、TechCrunchがReplitのアムジャド・マサドCEOの発言を報じました。同社はもうAnthropicと協業していない、理由は料金・提携の条件・性能だという内容です。性能についてはOpenAIのSolとAstraのほうが、ゼロからアプリを作る仕事では成績が良かったと語ったと伝えられています。
ただし同じ記事で、提携の事情を知る人物が「提携はまだ続いている」と述べており、当事者の説明は食い違ったままです。Replit自身が9月29日に公開した技術記事には、Claude Fable 5.1とGPT-6 Astraを本番のReplit Agentで1週間ずつ動かした計測が載っています。Anthropic側の公式見解は、本記事の公開時点では確認できていません。
両社公式の料金ページで確かめると、Claude Fable 5.1とGPT-6 Astraの標準価格は入力10.00ドル・出力50.00ドルで同額でした。それどころか、入力27.2万トークンを超えたときの単価(Astraは20.00ドル・75.00ドル、Fable 5.1は据え置き)とキャッシュの読み出し(0.25ドル対1.00ドル)では、Claudeのほうが安く付きます。中位層のSonnet 5.5とGPT-6.1 Solも、標準は入力2.00ドル・出力10.00ドルで同額です。
値札に出ない差として確かめられたのは、Claude 4.7以降のトークナイザが同じ文章から約30%多いトークンを生むという、Anthropic自身の記述でした。もう1つの理由である提携の条件は公表されていないため、検算はできません。
Replitの料金ページとAgentのドキュメントには、モデル名が1つも書かれていません。仕入れ先が入れ替わっても、使う側の画面には何も出ない作りになっています。
TechCrunchはReplitに説明を求め、回答があれば記事を更新するとしている。次に何かが分かるとすれば、その更新か、Replitのモデル選択画面にClaudeの名前が残っているかどうかのどちらかだ。公表されている値札が同額だったという一点だけは、どちらに転んでも動かない。