Reflection AIが2026年10月16日、同月5日に発表していたオープンウェイトモデル「Beam」の重みを公開した。ライセンスはApache 2.0、形式はBF16・FP8・NVFP4の3種で、Hugging Faceから取得できる。発表直後の記事で「まだ出ていない」と整理した3点のうち、重みと価格の2つが埋まり、第三者の測定も1件出ている。
数字を先に並べる。ホスティング事業者の掲載価格は、Basetenが100万トークンあたり入力1.30ドル・出力4.30ドル、OpenRouterの掲載は入力0.25ドル・出力1.00ドルからだ。そして第三者機関Artificial Analysisの総合指数(Intelligence Index)は30で、同じ一覧のGLM-5.2は34、Kimi K3は44だった。
オープンウェイトとは、モデルの中身(重み)が公開され、誰でもダウンロードして自前の環境や好きなホスティング事業者で動かせる形のことだ。ChatGPTやClaudeのように、1社の窓口からしか使えない形とは違う。
一言でまとめると──「待っていた重みと価格は出たが、第三者の測定は自社の成績表より控えめだった」。安く動かせる候補は増えましたが、ChatGPTやClaudeの代わりにする理由は、まだ見つかっていません。
⚠ 情報の鮮度について
一次情報はReflection AIの公式ブログとモデルカード(いずれも2026年10月16日付)、BasetenとOpenRouterの掲載ページ、Artificial Analysisの各モデルのページです。重みの公開から約4日がたっているため、速報ではなく、前回記事の続報として意味を整理します。価格と指数は2026年10月20日に各ページで確認した時点の値で、ホスティング各社の単価はその後に変わる可能性があります。
Section 01
Reflection Beamの重みが公開された──前回の3つの宿題はどうなったか
発表直後の時点で、Beamについて分からなかったのは重みの公開日、価格、第三者の測定の3つだった。10月20日朝の時点を並べ直すと、次のようになる。
| 確認したい点 | 10月6日の記事の時点 | 10月20日朝の時点 |
|---|---|---|
| 重みの公開 | 「10月後半」、日付は未定 | 10月16日に公開。Apache 2.0、BF16・FP8・NVFP4 |
| 価格 | 未公表 | 事業者の掲載あり(Baseten 入力1.30ドル/出力4.30ドル) |
| 第三者の測定 | なし | 10月16日付でArtificial Analysisが指数30を掲載 |
公式ブログによれば、配布するのは3形式の重みと、推測デコーディング(小さな補助モデルが先読みして生成を速める仕組み)用の補助モデルだ。サーバー側のソフトでは、vLLMやSGLangなどが初日から対応し、ローカル向けのOllamaやLM Studioも対応先に名を連ねる。
ただし、置き場所の問題は残る。Beamは1トークンごとに230億だけ動かす設計だが、次にどの専門家が呼ばれるかは分からないため、全体の5,010億を記憶領域に載せておく必要がある。動かす量は小さくても、置く量は小さくならない。一般的なパソコン1台で動かす規模ではなく、自前で動かすなら複数のGPUを積んだサーバーが前提になる。
もう一つ、数字が動いた点がある。公式のモデルカードに載った成績は、公式ブログの成績表と少しずつ違う。
| 指標 | 公式ブログの成績表(10月8日更新) | 10月16日のモデルカード |
|---|---|---|
| SWE-bench Verified | 80.9 | 81.6 |
| MCP Atlas | 78.7 | 80.8 |
| GPQA Diamond | 90.5 | 90.6 |
| AIME 2026 | 97.8 | 97.7 |
| BrowseComp(文脈管理あり) | 77.4 | 76.8 |
| Terminal Bench 2.1 | 80.1 | 80.1 |
最大でもMCP Atlasの2.1点差で、順位が入れ替わるほどの動きではない。モデルカードの数字は、BF16形式を温度0.7・top_p 0.99で測ったものと明記されている。発表時の成績表にこの条件の記載は見つからなかったため、差が測り方の違いによるものかは分からない。いずれも、測ったのはReflection自身だ。
Section 02
Reflection Beamの料金は──掲載先ごとに単価が違う
重みが公開されたことで、Beamは誰でもホスティングできるようになった。単価は、Reflectionが一つに決めるものではなく、動かす事業者ごとに決まる。確認できた2つの掲載を並べる。
| 掲載先(100万トークンあたり) | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| Basetenの公式ライブラリ | 1.30ドル | 0.13ドル | 4.30ドル |
| OpenRouterの掲載(最低価格) | 0.25ドル | 掲載なし | 1.00ドル |
入力は1.30ドルが0.25ドルの5.2倍、出力は4.30ドルが1.00ドルの4.3倍になる。たとえば入力100万トークン・出力20万トークンの作業を1回流すと、Basetenでは2.16ドル、OpenRouterの最低価格では0.45ドルだ。同じ重みでも、どこで動かすかで請求額は4倍以上変わる。キャッシュ入力は、Basetenの0.13ドルが入力単価の10分の1にあたり、同じ文脈を繰り返し送る使い方では実質の単価がさらに下がる。
Reflection自身のAPIは公開ベータで、公式ブログは「無料で始められる」と述べるにとどまり、単価は示していない。
💡 この表を読むときの注意
ここで比べたのは、各掲載先が見出しに出している単価だけです。文脈長によるしきい値、バッチ処理の割引、速度モードの別料金は比べていません。また、第三者の集計では、OpenRouterの最低価格の経路は出力速度が毎秒4トークン前後で、最初の応答まで30秒台かかると報告されています(※観測)。安さの代わりに待ち時間を払っている可能性があるため、使う経路の速度と対応機能を確かめてから選ぶのが確実です。
Section 03
第三者の測定で、Beamはどこにいるのか
前回の記事は、成績表がすべて発表元の自己申告だと書いた。その後、第三者機関のArtificial Analysisが、BeamのIntelligence Indexを30と掲載した。複数の試験を合成した総合指数で、各モデルのページから確認できる。
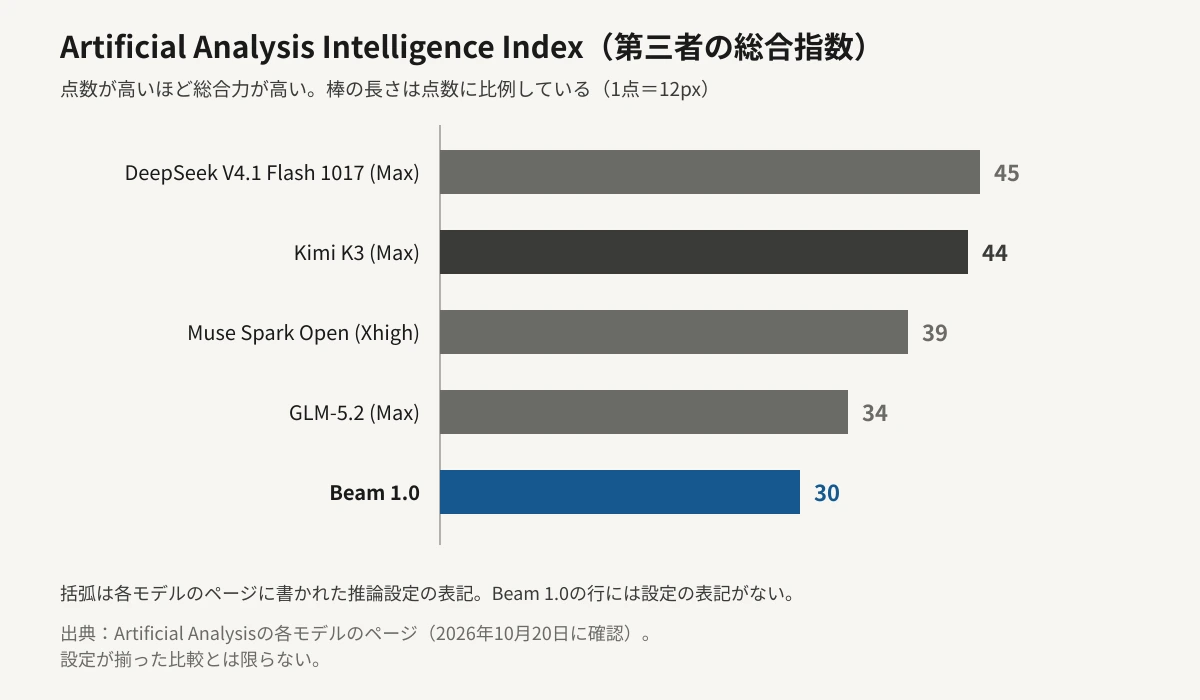
Beamは30で、図の5モデルの中では最も低い。GLM-5.2とは4点差、Kimi K3とは14点差だ。同じ一覧には、以前に取り上げたDeepSeek V4.1 Flash 1017が45、Metaの公開モデルMuse Spark Openが39で並んでいる。
Reflectionは発表時、高度な推論の試験でGLM-5.2と同等の得点を、3〜4分の1の推論計算量で出せると述べていた。指数の4点差は、この主張を否定するものではない。測っているものが違うからだ。Reflectionの数字は「同じ得点を出すために使う計算量」を、指数は「複数の試験を合成した総合力」を見ている。ただ、総合力で見れば、Beamは首位争いのモデルではないという点は、第三者の測定でも変わらなかった。
Artificial Analysisは、重みの公開と同じ10月16日付でBeamを論じる記事も出している。それによれば、30は米国発のオープンウェイトではMetaのMuse Spark Open(39)に次ぐ位置で、オープンウェイト全体では10番目にあたる。タスク1件あたりの出力は約2.6万トークンと少なく、指数が1点上のUAEのK2 Horizon(31)の約5.2万トークンの半分で済んでいる。Reflectionが前面に出した「効率」は、この点では裏づけられた形だ。
一方で、コーディング用の別指標は28にとどまり、首位の68から40点離れている。同社はエージェント的な作業には強く、ターミナル操作には弱いと整理している。ページには価格の中央値として入力0.70ドル・出力2.10ドル、出力速度は毎秒324.2トークンとも載っており、安さと速さで選ぶモデルとして位置づけるのが、いまの数字には合う。
ⓘ 指数の読み方について
図の括弧は、各モデルのページに書かれた推論設定の表記です。Beam 1.0の行には設定の表記がなく、他のモデルと設定が揃った比較とは限りません。同じモデルでも設定を変えると点数が動くため、30は暫定の値として受け取るのが安全です。
Section 04
あなたのAI選びは変わるのか
結論から言えば、画面から使うAIの選び方は変わらない。立場ごとに分ける。
B
Cursor・GitHub Copilotで選ぶ人:まだ選べない
両ツールが標準のモデル一覧にBeamを加えたという発表は、確認した範囲では見つからなかった(※観測)。使えるようになるまでは、いまの設定のままでよい。
C
自前やAPIでモデルを使う開発者・企業:評価候補に入れる
Apache 2.0で使える米国発の大型モデルが、掲載先によっては入力0.25ドルから使える。自社のタスク数十件で、速度と正答の両方を測ってから決める段階だ。
開発者・企業の立場では、数字の見方がもう一つある。指数が30でも、用途がコード修正や定型の自動化に絞られるなら、足りることは多い。逆に、難問を解かせる用途や、判断の質が成果を左右する用途では、44のKimi K3や45のDeepSeek V4.1 Flash 1017との差がそのまま出る。安い掲載先の価格を見る前に、自分の仕事がどちら側かを決めておくと、比較がぶれない。
Section 05
編集部の見立て
Editor's Opinion
今回目を引いたのは、同じ重みに付く値札の開きです。入力で5.2倍、出力で4.3倍という差は、モデルの性能差ではなく、どこで動かすかという運用の差から生まれています。オープンウェイトの本当の価値は、ライセンスよりも、この「動かす場所を選べる」点にあるのかもしれません。
一方で、指数30という数字は、難しい仕事を任せる材料にはなっていません。第三者の測定は、タスクあたりの出力が少ないという効率の主張を裏づけましたが、コーディング用の別指標は28です。安く速く動くことと、難しい仕事を任せられることは別の軸だと分かります。発表時にKimi K3が上だと認めていた姿勢と、第三者の測定は、いまのところ矛盾していません。
Cursorのようなコーディングツールを使う方にとって、次の分岐点は、ツール側がBeamを選択肢に加えるかどうかです。加わるなら、その時の単価と指数の更新があわせて判断材料になります。
Section 06
まとめ
Reflection AIが2026年10月16日、Beamの重みをApache 2.0で公開しました。形式はBF16・FP8・NVFP4の3種で、総パラメータ5,010億、1トークンごとに動くのは230億です。
ホスティングの掲載価格は、Basetenが入力1.30ドル・出力4.30ドル、OpenRouterは入力0.25ドル・出力1.00ドルからで、入力は5.2倍の開きがあります。比べたのは見出しの単価だけで、速度や割引の条件は含みません。
第三者のArtificial Analysisが掲載した総合指数は30で、GLM-5.2の34、Kimi K3の44を下回りました。一方、タスクあたりの出力が少ない点は裏づけられています。推論設定の表記がない行のため、暫定の値として扱うのが安全です。
ChatGPT・Claude・Geminiの画面から使う人の選び方は変わりません。APIや自前運用を考える開発者は、自社のタスクで速度と正答を測ってから決めるのが現実的です。
次に確かめられるのは、Artificial AnalysisのBeamの行に推論設定の表記が付いて指数が更新されるかどうかと、CursorのモデルリストにBeamが並ぶ日が来るかどうかだ。