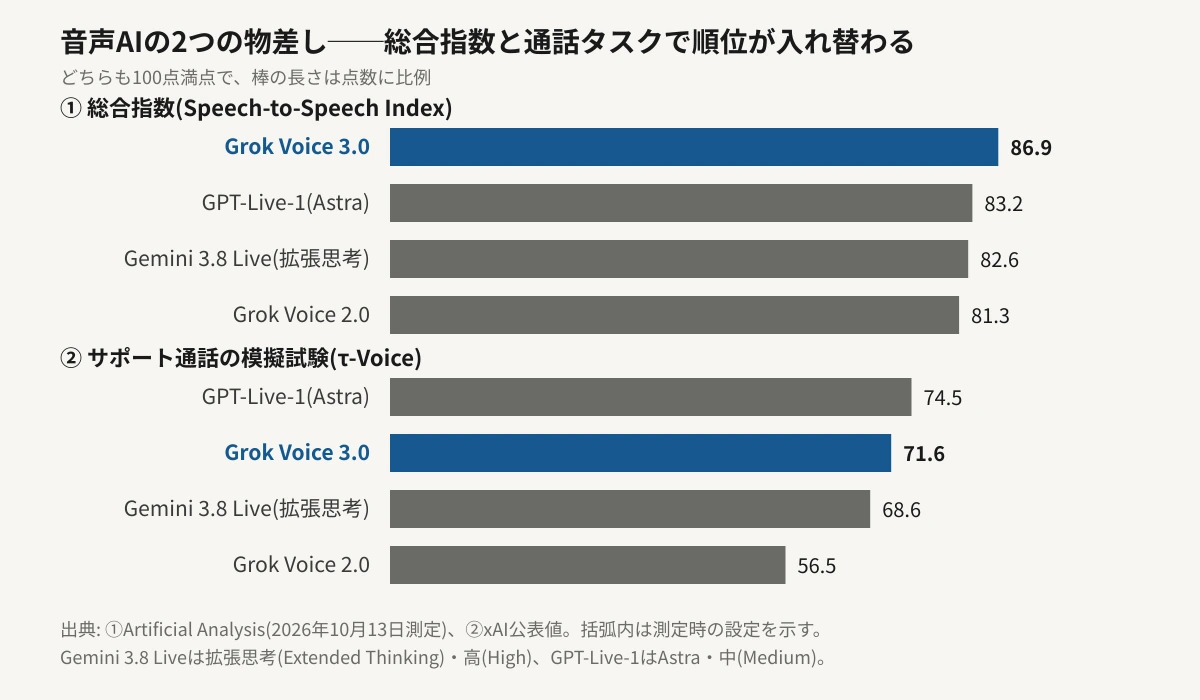
xAIが2026年10月14日、音声会話AIの新版「Grok Voice 3.0」を公開した。人の声を聞き取り、そのまま声で返す「音声から音声へ」のモデルで、企業が電話応対や営業の自動化に使う開発者向けの音声APIに載る。第三者機関Artificial Analysisの音声AI総合指数では86.9点で、2位のOpenAIのGPT-Live-1(83.2点)を3.7点上回った。
ただし、話はそこで終わらない。同じxAIの発表資料に載っているサポート通話の模擬試験では、順位が逆になる。こちらはGPT-Live-1が74.5%、Grok Voice 3.0が71.6%だ。音声AIは「首位」の中身を見ないと選べない段階に入っている。
⚠ 情報の鮮度について
一次情報はxAIの発表(2026年10月14日)とxAI開発者向けドキュメントのリリースノートで、Artificial Analysisの測定は10月13日付です。記事公開時点で約1日が経過しています。ベンチマークの数字は特記がない限りArtificial AnalysisまたはxAIの公表値で、導入実績(Starlink・Tesla)はxAI自身の申告です。
Section 01
Grok Voice 3.0とは──何が自動で切り替わったのか
Grok Voice 3.0は、Grokを提供するxAIの音声API向けモデルだ。音声を受け取って音声で返す方式(speech-to-speech)で、相手の話への割り込みや間の取り方も試験の対象になる。xAIは応答の遅れを1秒未満と説明している。
開発者にとっていちばん大きな変更点は、性能よりも切り替わり方にある。xAIのリリースノートによれば、grok-voice-latestという名前でモデルを呼んでいたセッションは、10月14日から自動的に3.0へ移った。従来の「Grok Voice 2.0」は非推奨(deprecated)に指定され、移行はgrok-voice-3.0またはgrok-voice-latestに書き換えるだけで済むとされている。
同じ「Grok Voice」の名前でも、8月に既定モデルが切り替わった際には価格が上がった。その経緯はGrok Voice Think Fast 2.0の記事に書いた。今回は価格が動かない代わりに、性能の測られ方が論点になっている。
| 指標(Artificial Analysis・xAI公表) | Grok Voice 2.0 | Grok Voice 3.0 | 変化 |
|---|---|---|---|
| 総合指数(100点満点) | 81.3 | 86.9 | +5.6点 |
| 通話の模擬試験 τ-Voice | 56.5% | 71.6% | +15.1ポイント |
| 割り込み・間の扱い Full Duplex Bench | 95.1% | 97.0% | +1.9ポイント |
| 音声での推論 Big Bench Audio | 97.2% | 98.5% | +1.3ポイント |
| 料金(1分あたり) | 0.08ドル | 0.08ドル | 据え置き |
一言でまとめると──「前の版からいちばん伸びたのは通話タスクの成績で、値段は動かなかった」。そして何もしていない開発者の側で、モデルだけが入れ替わりました。
Section 02
総合指数86.9点の首位は、何の点数なのか
Artificial Analysisの「Speech-to-Speech Index」は、音声AIの総合点を一つの数字にまとめた指数だ。xAIの説明では、音声での推論力、模擬通話での課題達成、そして人が通話を聞き比べて選ぶ好みの投票を組み合わせている。2026年10月13日の再測定で、上位は次の並びになった。
86.9
Grok Voice 3.0(1位)
83.2
GPT-Live-1(Astra・中)
82.6
Gemini 3.8 Live(拡張思考・高)
差は3.7点と4.3点で、旧版の81.3点からは5.6点上がっている。なお9月のGemini 3.8 Liveの記事ではGPT-Live-1が81.5点だったが、今回の83.2点は10月13日の測定値で、指数は測定のたびに数字が動く。注意したいのは、この表の名前がどれも設定込みの名前だという点だ。同じGPT-Live-1でも、Astra・中の設定の83.2点と、Sol・低の設定の80.1点が別々に並ぶ。Gemini 3.8 Liveの記事で紹介した82.6点も、拡張思考を高に設定した場合の数字である。
Section 03
通話タスクの試験では、GPT-Live-1が上にいる
総合指数の中には、サポート窓口を模した通話の試験「τ-Voice」が組み込まれている。訛りや背景の雑音を混ぜた模擬のサポート通話で、AIが本人確認や手続きを最後までやり切れるかを見る試験だ。xAIが示した結果は次のとおり。
- GPT-Live-1(Astra・中):74.5%
- Grok Voice 3.0:71.6%
- Gemini 3.8 Live(拡張思考・高):68.6%
- Grok Voice 2.0:56.5%
Grok Voice 3.0は旧版から15.1ポイント伸ばしたが、首位のGPT-Live-1とは2.9ポイント差が残る。xAI自身は、この結果を「GPT-Live-1と同程度で、応答までの時間は40%短い」と説明している。差が2.9ポイントなのは事実で、「同程度」と読むか「届いていない」と読むかは、その試験をどれだけ自社の通話に近いと見るかで決まる。40%短いという遅延の数字は、第三者の測定ではなくxAIの公表値だ。
なぜ総合は首位でも、この試験は2位なのか
01
総合指数は「平均点」
推論・好みの投票・課題達成を混ぜた指数なので、得意な項目が多いモデルが上に来る。Grok Voice 3.0は割り込みの扱いや推論で高い点を取っている。
02
通話の試験は「最後までやり切れるか」
窓口業務では、途中で聞き取りを誤ると手続き全体が失敗する。τ-Voiceは、その積み重ねを見る試験になっている。
03
どちらの首位も本当で、答えが違う
平均点の首位と、窓口業務の首位は別の問いへの答えだ。窓口の自動化が目的なら、見るべきは後者に近い。
Section 04
Grok Voice 3.0の料金は1分いくらか
料金は1分0.08ドル(1時間4.80ドル)で、Grok Voice 2.0と同じだ。xAIの料金ページには、どちらも同額で載っている。性能が上がったのに据え置かれたので、2.0から3.0へ自動で移った開発者の請求額は、通話時間が同じなら変わらない。
一方で、価格より実態に近い比較も出ている。Artificial Analysisが同じ課題(Big Bench Audio)を流して測った1課題あたりのコストだ。
| モデル | 1課題あたりの測定コスト | Grok Voice 3.0との比 |
|---|---|---|
| Grok Voice 3.0 | 0.025ドル | 基準 |
| GPT-Live-1(Astra・中) | 0.030ドル | 約20%高い |
| GPT-Realtime-2.1(高) | 0.055ドル | 約2.2倍 |
ⓘ この表は「定価」ではない
上の金額は、同じ課題を実際に流したときにかかった費用の実測値で、1分いくらという定価とは別物です。定価が安くても、長く話して使うモデルは1課題の費用が膨らみます。逆もあります。窓口業務の費用を見積もるときは、自社の通話1本あたりの長さで、実測コストを置き換えて計算してください。
Section 05
xAI自身が挙げた導入実績をどう読むか
発表資料には、実際の運用数字も並ぶ。Grok VoiceはTeslaとSpaceXをあわせて毎日数百万回の会話を処理し、Grok Botの音声モードも新モデルで動くという。SpaceXの衛星通信Starlinkの窓口では、1日およそ2万件の通話に応対し、約70%を人の手を介さずに解決、営業通話の4件に1件は通話中に購入で終わるとされる。
⚠ この数字は検証されていません
Tesla・Starlinkの運用数字はxAIの申告で、第三者による監査は付いていません。解決率や購入率には、モデルの出来だけでなく、どの通話を人に回すかという設計や台本も含まれます。※観測として受け取るのが妥当です。
もう一つ、ServiceNowが公開している企業向けの音声エージェント試験「EVA-Bench」でも、xAIは精度で最高の74%を得たとしている。発表資料によれば、ServiceNowのニティン・アガルワル氏は「EVA-Benchで新しい最適境界(Pareto frontier)を示した」と述べた。ただし、これもxAIが発表資料の中で示した数字である。
Section 06
編集部の見立て
Editor's Opinion
今回の発表でいちばん注目したいのは、首位の数字そのものより、首位が一つではなくなったことです。総合指数ではGrok Voice 3.0、サポート通話の模擬試験ではGPT-Live-1と、物差しごとに別のモデルが前に出ています。1か月前は総合指数の首位をGoogleが取っていました。音声AIの順位は、ニュースのたびに入れ替わる段階にあります。
電話応対や営業の自動化を検討している人にとっては、見る順番が変わります。まず総合指数で候補を絞り、次に自社の通話に近い試験の成績を見て、最後に自社の通話1本あたりの実測コストで比べる。この3段を踏まないと、「首位だから」で選んだモデルが、窓口の現場では手続きを最後までやり切れない、ということが起こりえます。
ChatGPTやGeminiの音声モードを日常で使っている人には、この比較はまだ直接の話ではありません。ここで比べているのは開発者向けのAPIのモデルで、アプリの音声モードそのものではないからです。Grok Botの音声モードが新モデルで動くという点は、アプリ側で試せる数少ない接点になります。
もう一つ気になるのは、grok-voice-latestのような「いつも最新」の名前で呼んでいた場合、利用者の確認なしに中身が入れ替わることです。今回は価格が据え置かれましたが、8月の切り替えでは価格が変わりました。通話の品質や課金が動いたとき、原因が自社の変更なのか、モデルの入れ替えなのかを後から切り分けられるよう、モデル名を明示して固定するかどうかは、いま決めておく価値があります。
Section 07
まとめ
2026年10月14日、xAIが音声AIの新版Grok Voice 3.0を公開しました。Artificial Analysisの総合指数は86.9点で首位となり、2位のGPT-Live-1(83.2点)を3.7点、Gemini 3.8 Live(82.6点)を4.3点上回っています。
ただし、サポート通話の模擬試験τ-VoiceではGPT-Live-1が74.5%、Grok Voice 3.0が71.6%と、順位が逆です。旧版Grok Voice 2.0の56.5%からは15.1ポイント伸びました。
料金は1分0.08ドル(1時間4.80ドル)で、2.0から据え置かれました。grok-voice-latestを使っていた開発者のセッションは、操作なしで3.0に切り替わり、2.0は非推奨になっています。TeslaやStarlinkでの運用実績はxAIの申告で、第三者の検証はありません。
2.0の廃止日は、今回確認できたリリースノートの範囲では示されていない。grok-voice-latestで動かしている通話システムがあるなら、次に確かめるのは、3.0に入れ替わった10月14日以降の通話記録で、本人確認や手続きの完了率が以前と変わっていないかどうかだ。